

Auf dieser Seite
Dein Android-Handy hat eine stärkere GPU als die meisten Laptops von 2018. Moderne Snapdragon-Chips haben eigene KI-Beschleuniger, die ungenutzt bleiben, während du 20 $ im Monat zahlst, damit KI auf dem Server von jemand anderem läuft. Das ändert sich gerade.
Off Grid ist eine kostenlose Open-Source-App, die KI-Modelle lokal auf deinem Android-Handy ausführt. Nach dem ersten Download des Modells brauchst du kein Internet mehr. Kein Konto. Keine Daten, die dein Gerät verlassen. Diese Anleitung zeigt dir die Einrichtung, die passenden Modelle und welche Leistung du auf deiner Hardware erwarten kannst.
| Play Store | GitHub |
Was du brauchst
Mindestens: 6 GB RAM und ein ARM64-Prozessor (jedes Handy der letzten vier bis fünf Jahre). Du kannst mit Modellen ab 80 MB anfangen.
Empfohlen: 8 GB RAM oder mehr, Snapdragon 8 Gen 2 oder neuer. Damit laufen Modelle mit 3 bis 7 Milliarden Parametern, die wirklich brauchbare Antworten liefern.
Der Unterschied zur Cloud-KI: Dienste wie ChatGPT und Claude nutzen Modelle mit Hunderten Milliarden Parametern auf Rechenzentrums-GPUs. Lokal auf dem Handy laufen kleinere Modelle (1 bis 7 Milliarden Parameter). Für komplexes Schlussfolgern sind sie weniger stark, aber für Alltägliches wie schnelle Fragen, Zusammenfassungen, Entwürfe und Dokumentanalyse sind sie erstaunlich gut.
Was Off Grid kann
Off Grid ist mehr als ein Text-Chatbot. Die App bringt sechs KI-Funktionen in einer App zusammen, alle auf deinem Gerät:
 Beispiel-Chat (iPhone) |
 Bildgenerierung (auf dem iPhone) |
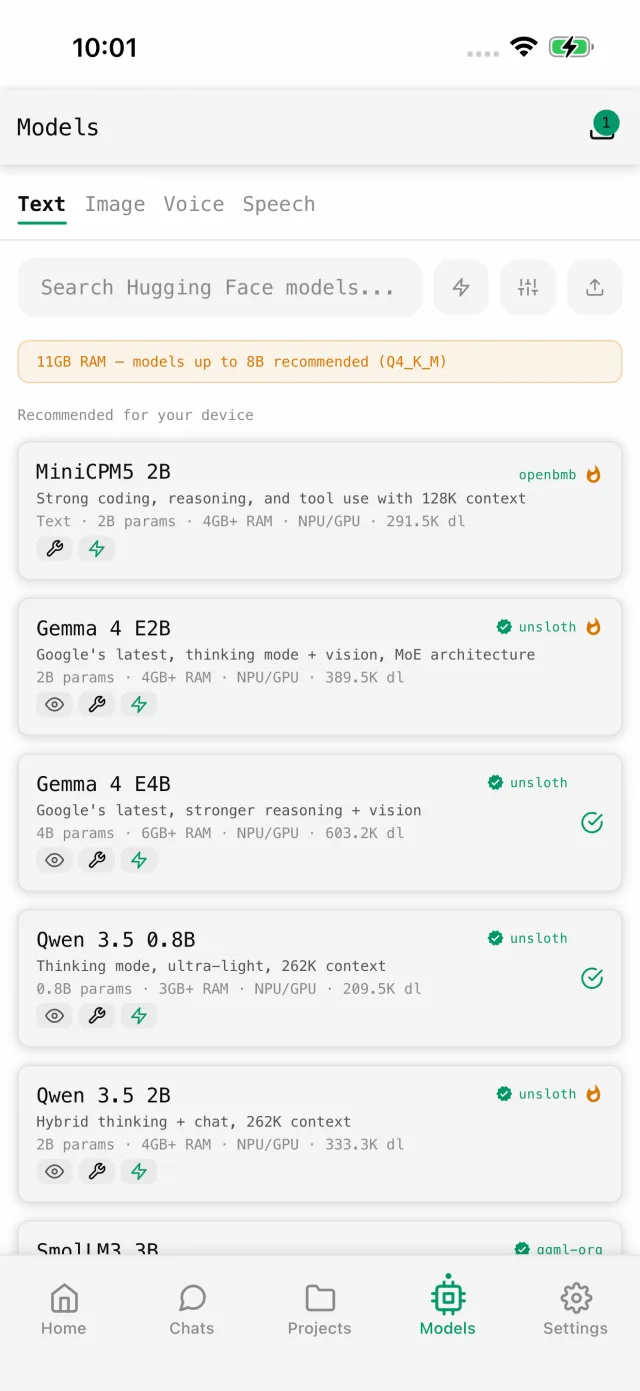 Verfügbare Modelle (iPhone) |
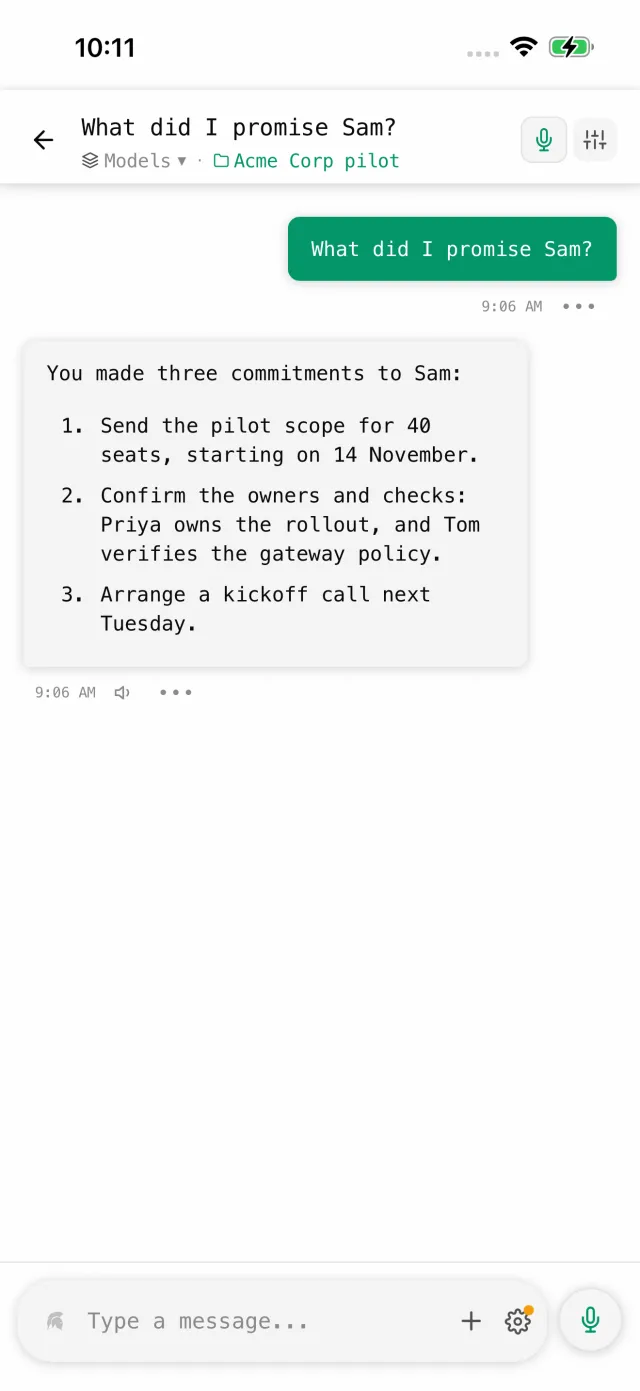 Projektdokumente (iPhone) |
Textgenerierung. Qwen 3, Llama 3.2, Gemma 3, Phi-4 oder jedes andere GGUF-Modell. Antworten erscheinen Wort für Wort, mit Markdown. 15 bis 30 Tokens pro Sekunde auf Top-Geräten, 5 bis 15 in der Mittelklasse.
Bildgenerierung. Stable Diffusion lokal, mit Live-Vorschau. Auf Snapdragon über die NPU beschleunigt (5 bis 10 Sekunden pro Bild). Über 20 Modelle, darunter Absolute Reality, DreamShaper und Anything V5.
Bilderkennung. Richte die Kamera auf etwas oder hänge ein Bild an und stell Fragen dazu. SmolVLM und Qwen3-VL brauchen auf Top-Geräten etwa 7 Sekunden.
Spracherkennung. Whisper wandelt Sprache lokal in Text um. Gedrückt halten zum Aufnehmen, Text erscheint schon während du sprichst. Kein Audio verlässt dein Handy.
Werkzeuge. Modelle mit Function Calling nutzen eingebaute Werkzeuge: Websuche, Taschenrechner, Datum und Uhrzeit, Geräteinfos. Das Modell verkettet sie automatisch, mit Schutz vor Endlosschleifen.
Dokumentanalyse. Hänge PDFs, Code-Dateien, CSVs und mehr an deine Unterhaltungen an.
Welche Modelle du nutzen solltest
Die Modellauswahl von Off Grid filtert nach dem RAM deines Geräts, damit du nichts lädst, was dein Handy nicht schafft. Das läuft auf echter Hardware:
Handys mit 6 GB RAM: Bleib bei Modellen mit 1 bis 2 Milliarden Parametern. Qwen 3 0.6B oder SmolLM3 sind ein guter Start. Rechne mit 5 bis 10 Tokens pro Sekunde, gut für kurze Antworten und einfache Aufgaben.
Handys mit 8 GB RAM: Der beste Kompromiss. Qwen 3 1.5B oder Phi-4 Mini liefern spürbar bessere Antworten. 10 bis 20 Tokens pro Sekunde auf aktuellen Snapdragon-Chips.
Handys mit 12 GB RAM oder mehr: Hier laufen 7B-Modelle wie Llama 3.2 7B oder Qwen 3 4B. Für viele Aufgaben kommen sie an das frühe ChatGPT heran. 15 bis 30 Tokens pro Sekunde auf dem Snapdragon 8 Gen 3.
Quantisierung zählt. Ein Q4_K_M-quantisiertes Modell braucht etwa halb so viel Speicher wie die volle Version, bei kaum schlechterer Qualität. Nimm auf dem Handy immer Q4 oder Q5.
Hast du schon Modelle geladen, kannst du eigene .gguf-Dateien aus dem Gerätespeicher importieren.
So funktioniert lokale KI auf deinem Handy
Bei lokaler KI werden die Modellgewichte in den RAM deines Handys geladen, und die Berechnung läuft auf deinem Prozessor. Es ist kein Server beteiligt. Nachdem du ein Modell von Hugging Face geladen hast, passiert jede Berechnung auf deinem Gerät.
Off Grid nutzt im Hintergrund llama.cpp, dieselbe Engine, die auch die meiste lokale KI auf dem Computer antreibt. Sie ist für ARM64 gebaut und nutzt jede Beschleunigung, die dein Handy bietet: die Neural Processing Unit von Qualcomm über QNN, die Adreno-GPU über OpenCL oder die CPU mit ARM-NEON-Befehlen.
Deine Unterhaltungen, Dokumente und Bilder berühren also nie ein Netzwerk. Probier es aus: Schalte den Flugmodus ein. Alles funktioniert weiter.
Hardware-Beschleunigung
Off Grid erkennt deine Hardware automatisch und nimmt den schnellsten Weg:
Snapdragon 8 Gen 1 oder neuer mit QNN: Die eigene Neural Processing Unit ist deutlich schneller und sparsamer als CPU oder GPU. Mit einem Snapdragon 8 Gen 2 oder Gen 3 ist das der schnellste Weg. Off Grid nutzt QNN automatisch, wenn es verfügbar ist.
Adreno-GPU über OpenCL: Auf den meisten Snapdragon-Handys verfügbar. Schneller als die CPU allein, gut für ältere Snapdragon-Geräte.
Nur CPU: Läuft überall. Langsamer, aber für kleinere Modelle brauchbar.
Der KV-Cache-Trick, der dein Tempo verdreifacht
Das ist der größte Geschwindigkeitsgewinn, den die meisten übersehen. Der KV-Cache speichert den Kontext deiner Unterhaltung. Standardmäßig nutzt er f16 (16-Bit-Gleitkomma). In den Einstellungen von Off Grid kannst du auf q4_0 (4-Bit-Quantisierung) umstellen.
Der Wechsel von f16 auf q4_0 verdreifacht die Geschwindigkeit ungefähr, bei den meisten Modellen kaum mit Qualitätsverlust. Nach deiner ersten Antwort schlägt dir die App diese Optimierung vor.
Speicher: die echte Grenze
Dein Handy hat 8 GB RAM, aber das System belegt 3 bis 4 GB davon. Für die KI bleiben dir also etwa 4 GB.
Als Faustregel gilt: Dateigröße des Modells × 1,5 = RAM, den es im Betrieb braucht (der Rest geht an KV-Cache und Zwischenwerte). Ein Modell mit 4 GB braucht also etwa 6 GB freien RAM.
Off Grid prüft vor jedem Laden den freien RAM und warnt dich, wenn ein Modell nicht passt. So stürzt die App nicht einfach ab, weil das System sie wegen zu viel Speicher beendet. Du bekommst eine verständliche Warnung statt einer App, die plötzlich zu ist.
Warum lokal statt in der Cloud
Lokale KI auf dem Handy macht dich von drei Dingen auf einmal unabhängig.
Kein Abo. Cloud-KI kostet ab 20 $ im Monat. Lokale KI ist nach dem einmaligen Download des Modells kostenlos.
Kein Internet. Lokale Modelle laufen im Flugzeug, im Keller und in Ländern mit eingeschränktem Internet. Ohne Verbindung gibt es keine Unterbrechung.
Keine Daten nach außen. Was du in eine Cloud-KI tippst, landet auf einem Server, den du nicht kontrollierst. Lokal bleiben deine Gesundheitsfragen, Rechtsdokumente, Tagebucheinträge und vertraulichen Arbeitsnotizen auf deinem Gerät. Off Grid ist Open Source, du musst niemandem beim Datenschutz einfach glauben. Lies den Code selbst.
So legst du los
- Installiere Off Grid aus dem Play Store
- Öffne die Modellauswahl und nimm ein empfohlenes Modell für den RAM deines Geräts
- Lade das Modell im WLAN herunter (zwischen 80 MB und über 4 GB)
- Schalte den Flugmodus ein, um zu prüfen, dass alles lokal läuft
- Fang an zu chatten
Die erste Antwort dauert länger, weil das Modell in den Speicher geladen wird. Danach geht es schneller. Stell in den Einstellungen den KV-Cache auf q4_0, dann ist es am schnellsten.
Wie es weitergeht
Die nächste Snapdragon-Generation von Qualcomm soll 200 Tokens pro Sekunde für lokale KI schaffen. Das Galaxy S26 von Samsung kommt mit eingebauter KI auf dem Gerät. Und neue Optimierungen holen aus immer kleineren Modellen immer mehr Qualität heraus.
Off Grid wird aktiv weiterentwickelt, jede Woche kommen neue Funktionen. Sprachmodus, Werkzeuge, einstellbarer KV-Cache und Bilderkennung kamen alle im letzten Monat dazu. Die neuesten Versionen findest du auf GitHub.
In einem Jahr ist lokale KI auf dem Handy kein Trick für Profis mehr, sondern der Normalfall.