

Auf dieser Seite
Der A17 Pro in deinem iPhone hat eine Neural Engine mit 16 Kernen und 35 Billionen Rechenoperationen pro Sekunde. Apple nutzt sie für die Fotobearbeitung und die Autokorrektur. Du kannst damit komplette KI-Modelle lokal ausführen: ohne iCloud, ohne Abo, ohne dass Daten dein Handy verlassen.
Off Grid ist eine kostenlose Open-Source-App, die KI-Modelle lokal auf deinem iPhone ausführt. Nach dem ersten Modell-Download brauchst du kein Internet mehr. Für die KI-Funktionen ist keine Apple-ID nötig. Es werden keine Daten verschickt. Dieser Leitfaden zeigt, wie du es einrichtest, welche Modelle auf iOS am besten laufen und welche Geschwindigkeit du erwarten kannst.
| App Store | GitHub |
Was du brauchst
Mindestens: ein iPhone mit 6 GB RAM (iPhone 13 Pro und neuer), A16- oder A17-Chip. Du kannst mit Modellen ab 80 MB anfangen.
Empfohlen: iPhone 15 Pro oder neuer (8 GB RAM). Damit laufen Modelle ab 3 Milliarden Parametern, die wirklich brauchbare Antworten liefern.
Was du gegenüber Cloud-KI aufgibst: Cloud-Dienste wie ChatGPT und Claude lassen Modelle mit Hunderten Milliarden Parametern auf Rechenzentrums-GPUs laufen. Lokal auf dem iPhone heißt: kleinere Modelle (1 bis 7 Milliarden Parameter). Bei komplexem Denken sind die Antworten weniger ausgefeilt, aber für Alltagsaufgaben wie schnelle Fragen, Zusammenfassungen, Entwürfe und Dokumentanalyse sind sie erstaunlich gut.
Was Off Grid kann
Off Grid ist mehr als ein Text-Chatbot. Es bringt sechs KI-Funktionen in einer App zusammen, alle lokal auf deinem Gerät:
 Beispiel-Chat (iPhone) |
 Bilderzeugung (iPhone) |
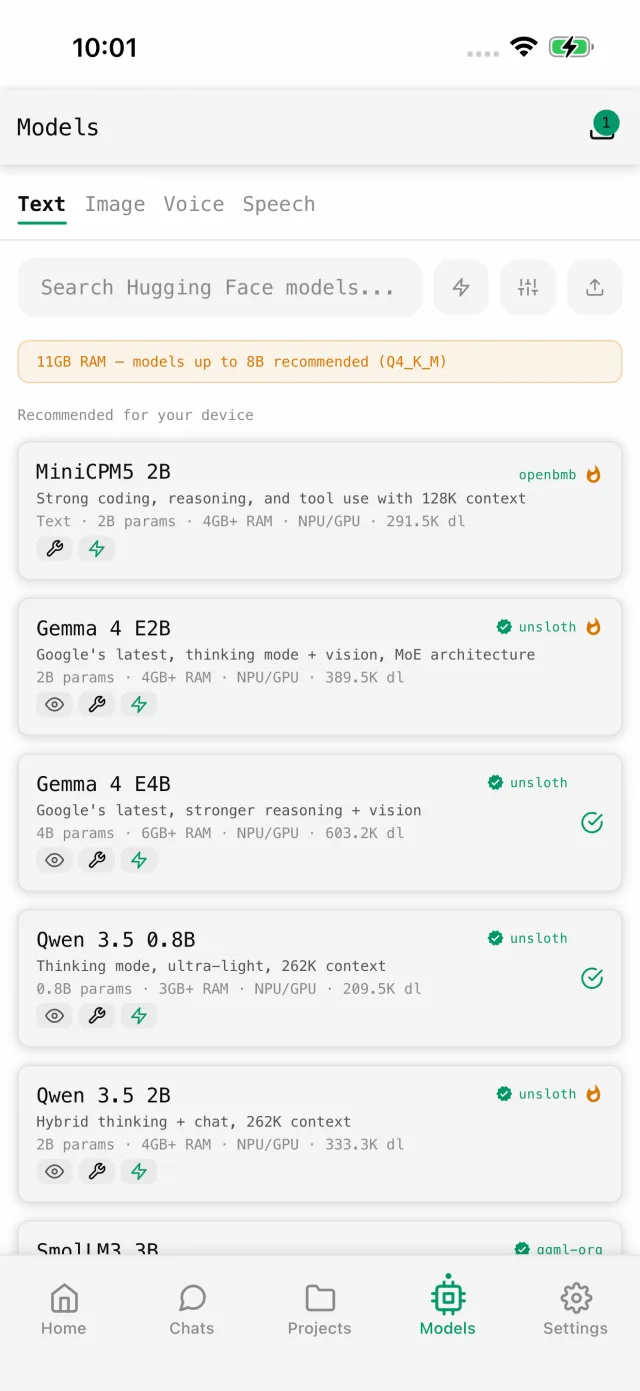 Verfügbare Modelle (iPhone) |
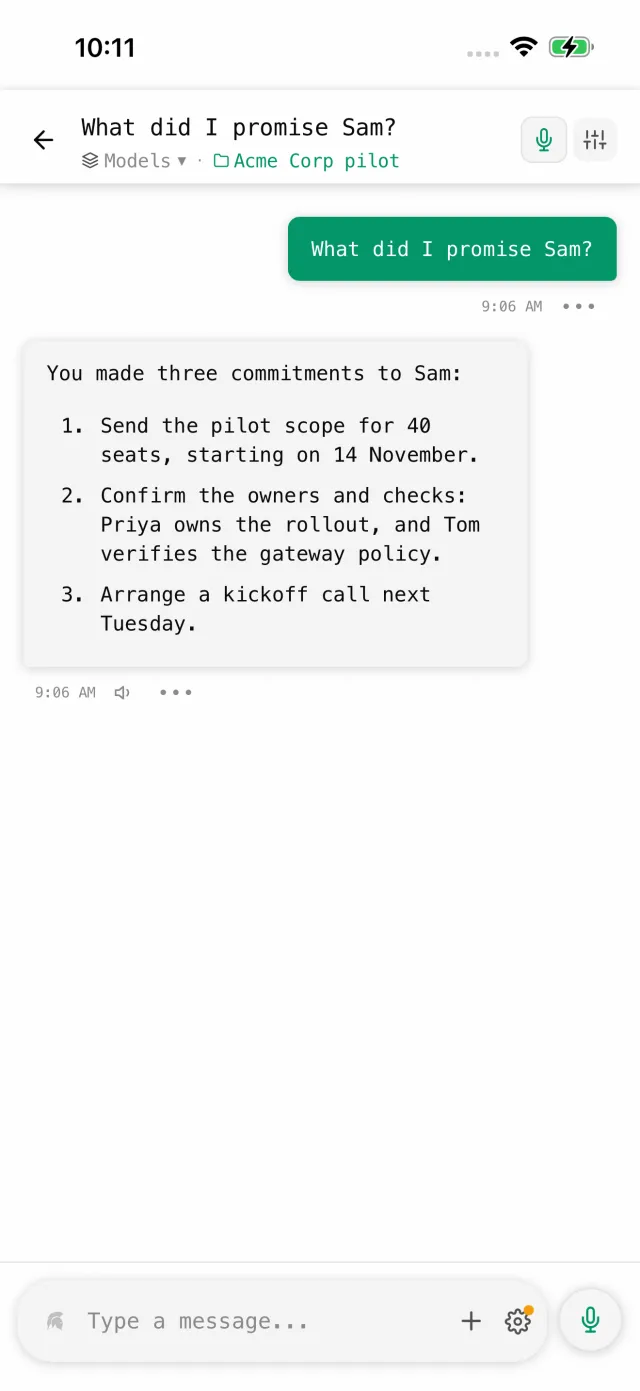 Projektdokumente (iPhone) |
Text. Nutze Qwen 3, Llama 3.2, Gemma 3, Phi-4 oder jedes andere GGUF-Modell. Antworten erscheinen Wort für Wort, mit Markdown-Darstellung. Metal-GPU-Beschleunigung auf allen aktuellen iPhones bringt dir 15 bis 25 Tokens pro Sekunde.
Bilder. Stable Diffusion lokal über Apples Core-ML-Pipeline, beschleunigt durch die Neural Engine. Dazu gehören SD 1.5, SD 2.1 und SDXL, optimiert für iOS.
Bilderkennung. Halt die Kamera auf etwas oder häng ein Bild an und stell Fragen dazu. SmolVLM und Qwen3-VL brauchen auf dem iPhone 15 Pro etwa 7 Sekunden.
Spracherkennung. Whisper lokal. Gedrückt halten zum Aufnehmen, die Abschrift erscheint schon während du sprichst. Kein Ton verlässt dein Handy.
Werkzeuge. Modelle mit Funktionsaufrufen nutzen eingebaute Werkzeuge: Websuche, Rechner, Datum und Uhrzeit, Geräteinfos. Das Modell verkettet sie automatisch, mit Schutz vor Endlosschleifen.
Dokumentanalyse. Häng PDFs, Code-Dateien, CSVs und mehr an deine Chats. Auf iOS liest PDFKit den Text direkt aus.
Welche Modelle du nutzen solltest
Der Modellbrowser von Off Grid filtert nach dem RAM deines Geräts, damit du nie etwas lädst, das dein iPhone nicht schafft. So sieht es auf echter Hardware aus:
iPhones mit 6 GB RAM (iPhone 13 Pro, 14 Pro): Bleib bei Modellen mit 1 bis 2 Milliarden Parametern. Qwen 3 0.6B oder SmolLM3 sind ein guter Start. Rechne mit 8 bis 12 Tokens pro Sekunde. Gut für kurze Antworten und einfache Aufgaben.
iPhones mit 8 GB RAM (iPhone 15 Pro, 16 Pro): Der beste Bereich. Qwen 3 1.5B oder Phi-4 Mini liefern spürbar bessere Antworten. 15 bis 25 Tokens pro Sekunde mit Metal-Beschleunigung.
Quantisierung zählt. Ein Q4_K_M-quantisiertes Modell braucht etwa halb so viel Speicher wie die volle Version, bei kaum Qualitätsverlust. Nimm auf dem Handy immer Q4 oder Q5.
Hast du schon Modelle heruntergeladen, kannst du eigene .gguf-Dateien aus dem Gerätespeicher importieren.
Wie lokale KI auf dem iPhone funktioniert
Bei lokaler KI werden die Modellgewichte in den RAM deines iPhones geladen, und die Berechnung läuft auf deinem Prozessor. Kein Server ist beteiligt. Nachdem du ein Modell von HuggingFace geladen hast, passiert jede Berechnung auf deinem Gerät.
Off Grid nutzt llama.cpp, kompiliert für Apple Silicon mit Metal-GPU-Beschleunigung. Dieselbe Engine steckt hinter den meisten lokalen KI-Apps auf dem Mac. Sie läuft direkt auf der GPU deines iPhones und ist deutlich schneller als reine CPU-Berechnung.
Für Bilder nutzt Off Grid Apples eigene Core-ML-Pipeline für Stable Diffusion auf der Neural Engine, für maximale Effizienz. Dieselbe Hardware, mit der Apple deine Fotos aufbereitet, erzeugt jetzt deine KI-Bilder.
Das Ergebnis: Deine Chats, deine Dokumente, deine Bilder berühren nie ein Netzwerk. Prüf es mit dem Flugmodus. Alles funktioniert.
Speichersicherheit auf iOS
iOS beendet Apps, die zu viel Speicher brauchen, ohne lange zu fackeln. Auch ein Modell, das rechnerisch in den RAM passt, kann beendet werden, wenn iOS den Speicher woanders braucht.
Off Grid prüft deshalb vor dem Laden. Bevor ein Modell geladen wird, berechnet es den tatsächlich nötigen RAM (Dateigröße x 1,5 bei Textmodellen) und vergleicht ihn mit dem freien Speicher. Auf Geräten mit 4 GB RAM oder weniger wird die GPU-Beschleunigung automatisch abgeschaltet, damit Metal nicht beim Speicherzuweisen abstürzt.
Passt ein Modell nicht, siehst du einen klaren Hinweis, statt dass sich die App einfach schließt.
Der KV-Cache-Trick, der die Geschwindigkeit verdreifacht
Das ist der größte Leistungsgewinn, den die meisten übersehen. Der KV-Cache speichert den Kontext deines Gesprächs. Standardmäßig nutzt er f16 (16-Bit-Gleitkomma). In den Einstellungen von Off Grid kannst du auf q4_0 (4-Bit-Quantisierung) umstellen.
Von f16 auf q4_0 verdreifacht sich die Geschwindigkeit ungefähr, bei den meisten Modellen mit kaum merklichem Qualitätsverlust. Nach der ersten Antwort weist dich die App darauf hin.
Warum lokal statt in der Cloud
Lokale KI auf dem iPhone nimmt dir drei Abhängigkeiten auf einmal ab.
Kein Abo. Cloud-KI kostet ab 20 $ im Monat. Lokale KI ist nach dem einmaligen Modell-Download kostenlos.
Kein Internet. Lokale Modelle laufen im Flugzeug, im Keller, überall. Ohne Verbindung keine Unterbrechung.
Keine Datenpreisgabe. Was du in eine Cloud-KI tippst, landet auf einem Server, den du nicht kontrollierst. Lokal bleiben deine Gesundheitsfragen, Rechtsdokumente, Tagebucheinträge und Arbeitsnotizen auf deinem Gerät. Off Grid ist Open Source. Du musst niemandem seine Datenschutzversprechen glauben, du kannst den Code selbst lesen.
Im Vergleich zu Apple Intelligence
Apple Intelligence erledigt manche Aufgaben auf dem Gerät und schickt andere über Apples Private-Cloud-Compute-Server. Es ist auf Apples eigene Modelle und Apples Ökosystem beschränkt. Du kannst kein Modell wählen, nicht prüfen, was lokal und was in der Cloud läuft, und es nicht auf Android nutzen.
Off Grid führt alles lokal aus. Du wählst das Modell. Du prüfst den Code. Es läuft auf iOS, Android und macOS. Kein geschlossenes System.
So legst du los
- Installiere Off Grid aus dem App Store
- Öffne den Modellbrowser und wähl ein empfohlenes Modell für den RAM deines Geräts
- Lade das Modell über WLAN (80 MB bis über 4 GB)
- Schalte den Flugmodus ein, um zu prüfen, dass es lokal läuft
- Leg los
Die erste Antwort dauert länger, weil das Modell in den Speicher geladen wird. Danach geht es schneller. Stell in den Einstellungen den KV-Cache auf q4_0, dann ist es am schnellsten.
Off Grid läuft über Mac Catalyst auch nativ auf Macs mit Apple Silicon. Dieselbe App, dieselben Modelle, derselbe Datenschutz.
Wie es weitergeht
Apples nächste Chipgeneration dürfte lokale KI noch schneller machen, und neue Optimierungen holen aus kleineren Modellen immer mehr Qualität. Der Abstand zwischen lokaler und Cloud-KI wird jedes Quartal kleiner.
Off Grid wird aktiv weiterentwickelt, jede Woche kommen neue Funktionen. Die neuesten Versionen findest du auf GitHub.
In einem Jahr ist lokale KI auf dem Handy kein Trick für Profis mehr, sondern der Normalfall.