

En esta página
Tu celular Android tiene una GPU más potente que la mayoría de las laptops de 2018. Los chips Snapdragon modernos tienen aceleradores de IA dedicados que no hacen nada mientras pagas 20 $ al mes para usar IA en el servidor de otra persona. Eso está cambiando.
Off Grid es una app gratuita y de código abierto que ejecuta modelos de IA en tu celular Android. No necesitas internet después de descargar el modelo por primera vez. Sin cuenta. Sin datos que salgan de tu dispositivo. Esta guía explica cómo configurarla, qué modelos usar y qué rendimiento esperar en tu hardware.
| Play Store | GitHub |
Lo que necesitas
Mínimo: 6 GB de RAM y un procesador ARM64 (cualquier celular de los últimos cuatro o cinco años). Puedes empezar con modelos de apenas 80 MB.
Recomendado: 8 GB de RAM o más, Snapdragon 8 Gen 2 o más nuevo. Así puedes usar modelos de 3 a 7 mil millones de parámetros que dan respuestas realmente útiles.
La diferencia con la IA en la nube: servicios como ChatGPT y Claude usan modelos de cientos de miles de millones de parámetros en GPUs de centros de datos. En tu celular corren modelos más chicos (de 1 a 7 mil millones de parámetros). Son menos fuertes para razonamientos complejos, pero para el día a día (preguntas rápidas, resúmenes, borradores y análisis de documentos) rinden sorprendentemente bien.
Lo que puede hacer Off Grid
Off Grid no es solo un chatbot de texto. Reúne seis funciones de IA en una sola app, todas en tu dispositivo:
 Chat de ejemplo (iPhone) |
 Generación de imágenes (en iPhone) |
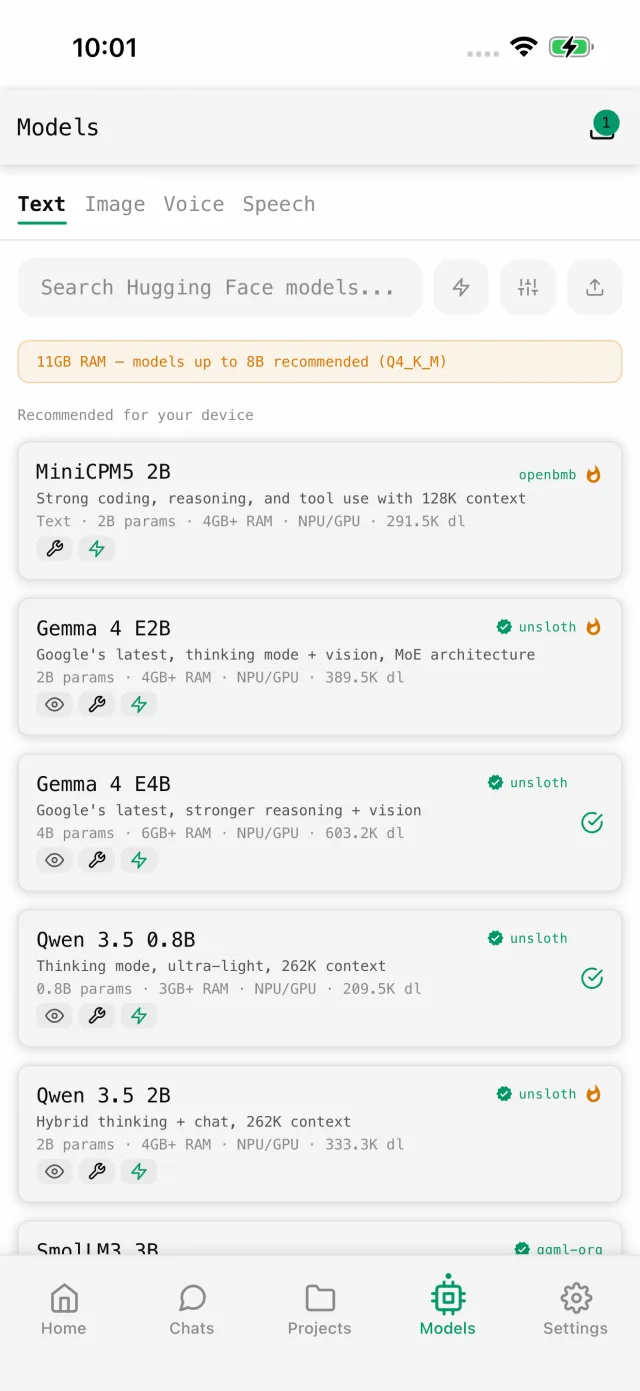 Modelos disponibles (iPhone) |
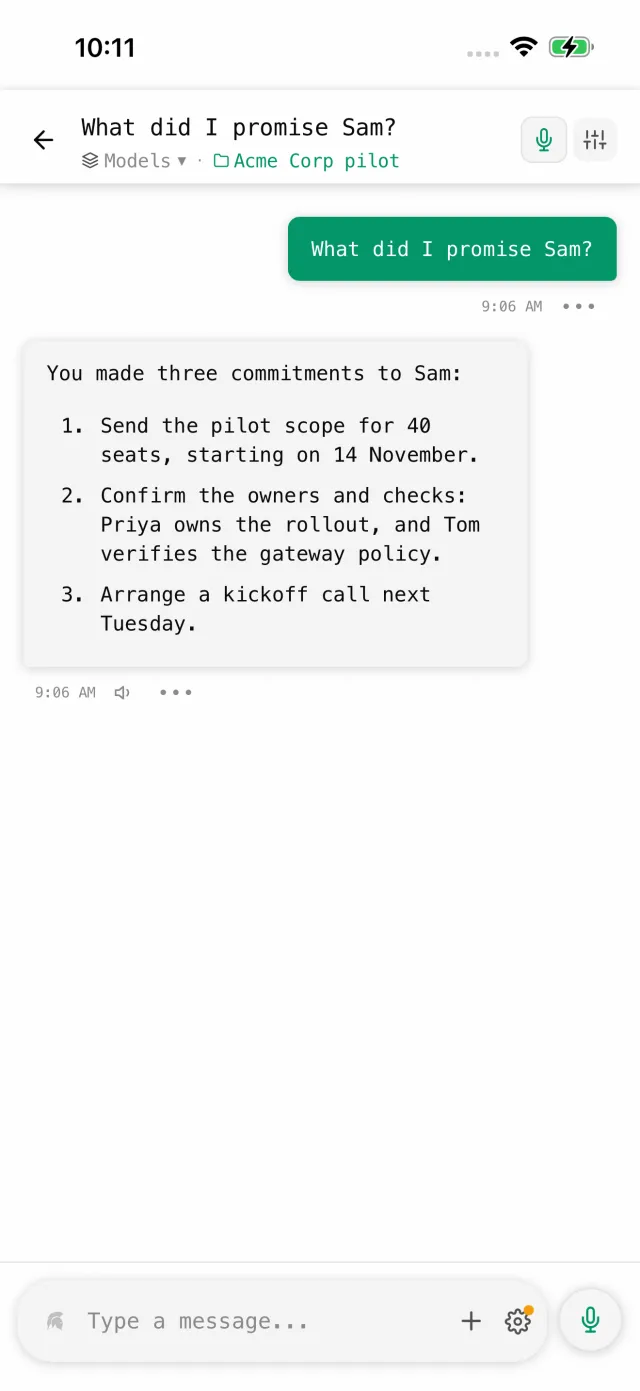 Documentos del proyecto (iPhone) |
Generación de texto. Qwen 3, Llama 3.2, Gemma 3, Phi-4 o cualquier modelo GGUF. Las respuestas aparecen palabra por palabra, con markdown. De 15 a 30 tokens por segundo en gama alta y de 5 a 15 en gama media.
Generación de imágenes. Stable Diffusion local con vista previa en tiempo real. Acelerada por la NPU en Snapdragon (de 5 a 10 segundos por imagen). Más de 20 modelos, como Absolute Reality, DreamShaper y Anything V5.
Visión. Apunta la cámara a algo o adjunta una imagen y haz preguntas sobre ella. SmolVLM y Qwen3-VL responden en unos 7 segundos en gama alta.
Transcripción de voz. Whisper convierte tu voz en texto de forma local. Mantén presionado para grabar y el texto aparece mientras hablas. El audio nunca sale de tu celular.
Herramientas. Los modelos con llamada a funciones usan herramientas integradas: búsqueda web, calculadora, fecha y hora, información del dispositivo. El modelo las encadena solo, con protección contra bucles infinitos.
Análisis de documentos. Adjunta PDF, archivos de código, CSV y más a tus conversaciones.
Qué modelos usar
El explorador de modelos de Off Grid filtra según la RAM de tu dispositivo, así nunca descargas algo que tu celular no puede correr. Esto funciona en hardware real:
Celulares con 6 GB de RAM: quédate con modelos de 1 a 2 mil millones de parámetros. Qwen 3 0.6B o SmolLM3 son buenos para empezar. Espera de 5 a 10 tokens por segundo, suficiente para respuestas cortas y tareas simples.
Celulares con 8 GB de RAM: el punto ideal. Qwen 3 1.5B o Phi-4 Mini dan respuestas notablemente mejores. De 10 a 20 tokens por segundo en Snapdragon recientes.
Celulares con 12 GB de RAM o más: puedes usar modelos 7B como Llama 3.2 7B o Qwen 3 4B. En muchas tareas se acercan al primer ChatGPT. De 15 a 30 tokens por segundo en Snapdragon 8 Gen 3.
La cuantización importa. Un modelo cuantizado en Q4_K_M usa más o menos la mitad de memoria que la versión completa, con una pérdida mínima de calidad. En el celular, elige siempre Q4 o Q5.
Si ya tienes modelos descargados, puedes importar tus propios archivos .gguf desde el almacenamiento del dispositivo.
Cómo funciona la IA local en tu celular
Con IA local, los pesos del modelo se cargan en la RAM del celular y los cálculos corren en tu procesador. No interviene ningún servidor. Después de descargar un modelo de Hugging Face, todo ocurre en tu dispositivo.
Off Grid usa llama.cpp por dentro, el mismo motor que mueve la mayoría de la IA local en computadoras. Está compilado para ARM64 y aprovecha la aceleración que tenga tu celular: la NPU de Qualcomm con QNN, la GPU Adreno con OpenCL o la CPU con instrucciones ARM NEON.
Así, tus conversaciones, documentos e imágenes nunca tocan una red. Puedes comprobarlo activando el modo avión: todo sigue funcionando.
Aceleración por hardware
Off Grid detecta tu hardware y elige solo el camino más rápido:
Snapdragon 8 Gen 1 o más nuevo con QNN: la NPU dedicada es mucho más rápida y eficiente que la CPU o la GPU. Con un Snapdragon 8 Gen 2 o Gen 3, es la opción más rápida. Off Grid usa QNN automáticamente cuando está disponible.
GPU Adreno con OpenCL: disponible en la mayoría de los celulares Snapdragon. Más rápida que la CPU sola, buena opción para Snapdragon más viejos.
Solo CPU: funciona en todos. Más lenta, pero sirve para modelos chicos.
El truco del caché KV que triplica la velocidad
Es la mejora de rendimiento más grande y casi nadie la conoce. El caché KV guarda el contexto de tu conversación. Por defecto usa f16 (coma flotante de 16 bits). En los ajustes de Off Grid puedes cambiarlo a q4_0 (cuantización de 4 bits).
Pasar de f16 a q4_0 casi triplica la velocidad, con un impacto mínimo en la calidad en la mayoría de los modelos. La app te lo sugiere después de tu primera respuesta.
La memoria, el verdadero límite
Tu celular tiene 8 GB de RAM, pero el sistema usa de 3 a 4 GB. En la práctica te quedan unos 4 GB para la IA.
Una regla aproximada: tamaño del archivo del modelo × 1,5 = RAM que necesita al usarse (lo extra es para el caché KV y los cálculos intermedios). Un modelo de 4 GB necesita unos 6 GB de RAM libre.
Off Grid revisa la RAM disponible antes de cargar cada modelo y te avisa si no entra. Así evitas el cierre repentino que ocurre cuando el sistema mata una app que usa demasiada memoria. Ves un aviso claro en lugar de una app que se cierra sin explicación.
Por qué usar IA local en vez de la nube
La IA local en tu celular te libera de tres cosas a la vez.
Sin suscripción. La IA en la nube cuesta 20 $ al mes o más. La IA local es gratis después de descargar el modelo una vez.
Sin internet. Los modelos locales funcionan en un avión, en un sótano o en un país con internet restringido. Sin conexión no hay cortes.
Sin exponer tus datos. Lo que escribes en una IA en la nube queda guardado en un servidor que no controlas. En local, tus preguntas de salud, documentos legales, entradas de diario y notas de trabajo confidenciales nunca salen de tu dispositivo. Off Grid es de código abierto, así que no tienes que creerle a nadie sobre privacidad. Lee el código tú mismo.
Cómo empezar
- Instala Off Grid desde Play Store
- Abre el explorador de modelos y elige uno recomendado para la RAM de tu dispositivo
- Descarga el modelo con Wi-Fi (de 80 MB a más de 4 GB)
- Activa el modo avión para comprobar que todo corre en local
- Empieza a chatear
La primera respuesta tarda más porque el modelo se carga en memoria. Las siguientes son más rápidas. En los ajustes, cambia el caché KV a q4_0 para la mejor velocidad.
Lo que viene
Se espera que la próxima generación de Snapdragon de Qualcomm llegue a 200 tokens por segundo en IA local. El Galaxy S26 de Samsung trae IA integrada en el dispositivo. Y las técnicas de optimización sacan cada vez más calidad de modelos cada vez más chicos.
Off Grid está en desarrollo activo, con funciones nuevas cada semana. El modo de voz, las herramientas, el caché KV configurable y la visión llegaron todos el último mes. Mira las últimas versiones en GitHub.
Dentro de un año, usar IA local en tu celular no será un truco de expertos. Será lo normal.