

Sur cette page
Qwen 3.5 est la famille de petits modèles à poids ouverts la plus performante du moment. La petite série (0.8B, 2B, 4B, 9B) a été conçue dès le départ pour tourner sur l’appareil, pas distillée d’un modèle plus gros. Elle combine des Gated Delta Networks avec un mélange d’experts (MoE) clairsemé, gère plus de 200 langues et une fenêtre de contexte de 262K. Et tu peux la faire tourner en local sur ton téléphone Android.
Off Grid est une application gratuite et open source qui fait tourner Qwen 3.5 et d’autres modèles GGUF entièrement sur le matériel de ton téléphone. Pas de cloud. Pas de compte. Aucune donnée ne quitte ton appareil.
| Play Store | GitHub |
Quel modèle Qwen 3.5 pour ton téléphone
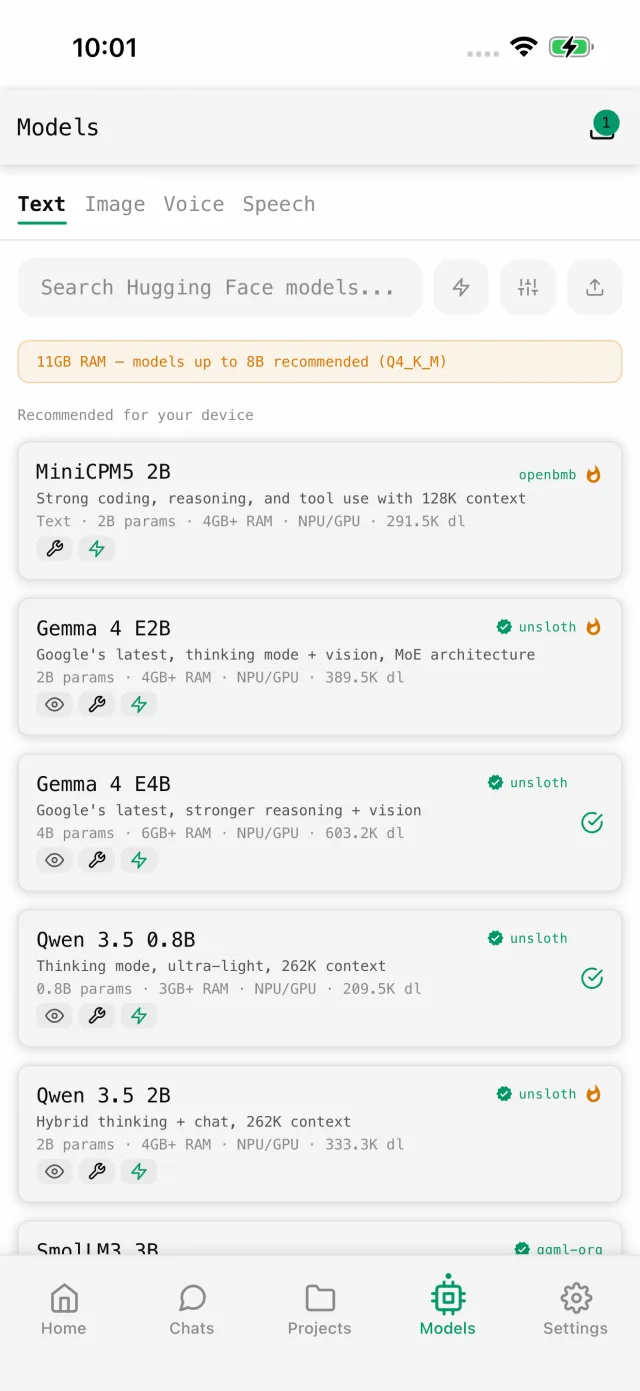
Qwen3.5-0.8B (Q4_K_M), environ 500 Mo. Tient sur n’importe quel téléphone avec 4 Go de RAM ou plus. Conçu pour l’appareil. Rapide : 15 à 25 tokens par seconde sur du milieu de gamme. Étonnamment capable pour sa taille grâce à l’architecture MoE, qui n’active qu’une partie de ses paramètres à chaque token.
Qwen3.5-2B (Q4_K_M), environ 1,2 Go. Le meilleur compromis pour les téléphones de 6 à 8 Go de RAM. Raisonne nettement mieux que le 0.8B. 10 à 18 tokens par seconde sur les Snapdragon récents. Bien pour écrire, coder et travailler en plusieurs langues.
Qwen3.5-4B (Q4_K_M), environ 2,5 Go. Demande 8 Go de RAM ou plus. C’est là que Qwen 3.5 devient vraiment impressionnant. Grâce à son architecture hybride, il fait bien mieux que son nombre de paramètres ne le laisse croire. Raisonnement en plusieurs étapes, analyse détaillée, génération de code.
Qwen3.5-9B (Q4_K_M), environ 5 Go. Demande 12 Go de RAM ou plus. Rivalise dans les benchmarks avec des modèles 20 fois plus gros. Si ton téléphone a la RAM, c’est le meilleur modèle ouvert que tu puisses faire tourner en local.
Pourquoi Qwen 3.5 plutôt qu’un autre
Architecture hybride. Qwen 3.5 Small n’est pas une version réduite d’un gros modèle. Il combine Gated Delta Networks et mélange d’experts, et n’active que les paramètres utiles à chaque token. Plus d’intelligence par octet de RAM qu’un modèle dense classique.
Plus de 200 langues. La prise en charge des langues la plus large de tous les modèles ouverts de cette taille. Si tu travailles en français, en hindi, en arabe, en japonais ou dans toute autre langue que l’anglais, Qwen 3.5 est le meilleur choix sur mobile.
Fenêtre de contexte de 262K. Les petits modèles précédents plafonnaient entre 8K et 32K. Qwen 3.5 Small gère 262K tokens : tu peux lui donner des documents entiers et tenir de longues conversations sans qu’il perde le fil.
Mode réflexion. Passe des réponses rapides au raisonnement étape par étape. Le mode réflexion montre le cheminement du modèle et donne de meilleurs résultats sur les problèmes complexes.
Multimodal. Qwen 3.5 comprend nativement le texte, les images et l’audio. Pointe l’appareil photo sur quelque chose et pose ta question.
Les performances sur du vrai matériel
| Modèle | Snapdragon 8 Gen 3 | Snapdragon 8 Gen 2 | Milieu de gamme |
|---|---|---|---|
| Qwen3.5-0.8B | ~25 tok/s | ~20 tok/s | ~12 tok/s |
| Qwen3.5-2B | ~18 tok/s | ~14 tok/s | ~8 tok/s |
| Qwen3.5-4B | ~12 tok/s | ~10 tok/s | ~5 tok/s |
| Qwen3.5-9B | ~8 tok/s | ~6 tok/s | - |
Passe le cache KV en q4_0 dans les réglages pour à peu près tripler ces vitesses.
Installer Qwen 3.5 dans Off Grid
- Installe Off Grid depuis le Play Store
- Ouvre le catalogue de modèles : les variantes de Qwen 3.5 sont dans les recommandations
- Choisis la taille qui correspond à ta RAM
- Télécharge-la en Wi-Fi
- Commence à discuter
Off Grid utilise tout seul l’accélération NPU avec QNN sur Snapdragon 8 Gen 1 et plus récents, le GPU Adreno via OpenCL sur les puces plus anciennes, et le CPU sur tout le reste.
Confidentialité
Chaque réponse de Qwen 3.5 est calculée sur le processeur de ton téléphone. Après le premier téléchargement, Off Grid ne fait aucune requête réseau. Active le mode avion et vérifie. Tout fonctionne.
Sans compte. Open source.
Off Grid génère aussi des images, comprend les photos, transcrit la voix, utilise des outils et analyse des documents, le tout sur l’appareil. Les dernières versions sont sur GitHub.