

In questa pagina
Il tuo telefono Android ha una GPU più potente della maggior parte dei portatili del 2018. I chip Snapdragon moderni hanno acceleratori dedicati all’IA che restano fermi mentre paghi 20 $ al mese per usare l’IA sul server di qualcun altro. Le cose stanno cambiando.
Off Grid è un’app gratuita e open source che fa girare modelli di IA in locale sul tuo telefono Android. Dopo il primo download del modello non serve internet. Nessun account. Nessun dato lascia il dispositivo. Questa guida spiega come configurarla, quali modelli usare e che prestazioni aspettarti sul tuo hardware.
| Play Store | GitHub |
Cosa ti serve
Minimo: 6 GB di RAM e un processore ARM64 (qualsiasi telefono degli ultimi quattro o cinque anni). Puoi iniziare con modelli da 80 MB.
Consigliato: 8 GB di RAM o più, Snapdragon 8 Gen 2 o successivo. Così puoi usare modelli da 3 a 7 miliardi di parametri che danno risposte davvero utili.
La differenza con l’IA nel cloud: servizi come ChatGPT e Claude usano modelli con centinaia di miliardi di parametri su GPU da data center. Sul telefono girano modelli più piccoli (da 1 a 7 miliardi di parametri). Sono meno forti nei ragionamenti complessi, ma per le cose di tutti i giorni (domande veloci, riassunti, bozze, analisi di documenti) sono sorprendentemente capaci.
Cosa fa Off Grid
Off Grid non è solo un chatbot di testo. Riunisce sei funzioni di IA in un’unica app, tutte sul tuo dispositivo:
 Chat di esempio (iPhone) |
 Generazione di immagini (su iPhone) |
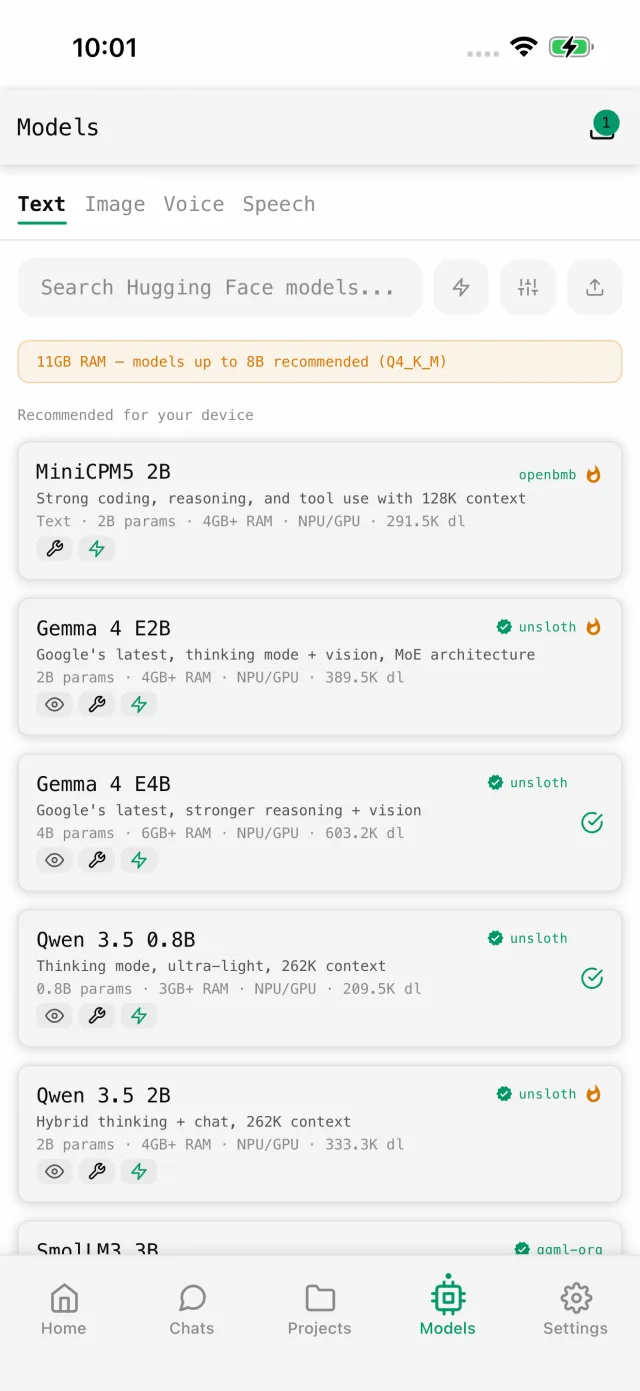 Modelli disponibili (iPhone) |
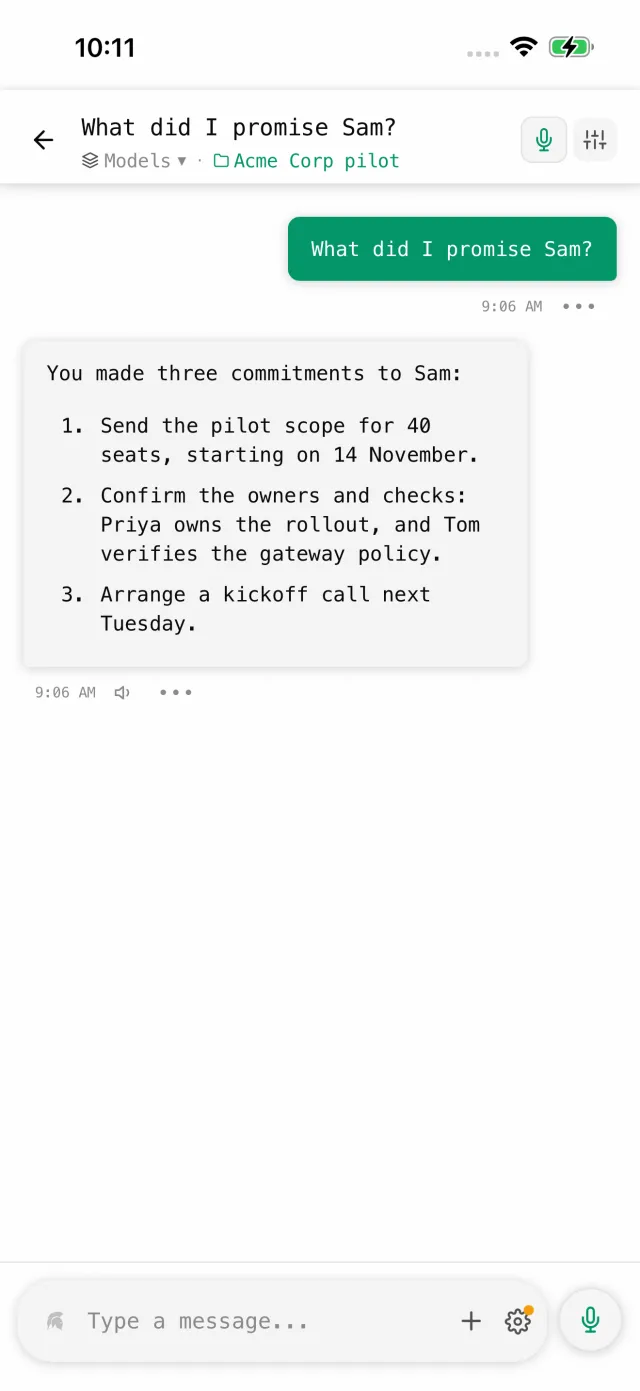 Documenti di progetto (iPhone) |
Generazione di testo. Qwen 3, Llama 3.2, Gemma 3, Phi-4 o qualsiasi modello GGUF. Le risposte appaiono parola per parola, con il markdown. Da 15 a 30 token al secondo sui top di gamma, da 5 a 15 sui medio gamma.
Generazione di immagini. Stable Diffusion in locale, con anteprima in tempo reale. Accelerata dalla NPU su Snapdragon (da 5 a 10 secondi per immagine). Oltre 20 modelli, tra cui Absolute Reality, DreamShaper e Anything V5.
Visione. Inquadra qualcosa con la fotocamera o allega un’immagine e fai domande. SmolVLM e Qwen3-VL rispondono in circa 7 secondi sui top di gamma.
Trascrizione vocale. Whisper trasforma la voce in testo, in locale. Tieni premuto per registrare e il testo appare mentre parli. L’audio non lascia mai il telefono.
Strumenti. I modelli che supportano le chiamate di funzione usano strumenti integrati: ricerca web, calcolatrice, data e ora, informazioni sul dispositivo. Il modello li concatena da solo, con una protezione contro i cicli infiniti.
Analisi di documenti. Allega PDF, file di codice, CSV e altro alle tue conversazioni.
Quali modelli usare
Il catalogo di Off Grid filtra in base alla RAM del dispositivo, così non scarichi mai un modello che il telefono non può far girare. Ecco cosa funziona su hardware reale:
Telefoni con 6 GB di RAM: resta su modelli da 1 a 2 miliardi di parametri. Qwen 3 0.6B o SmolLM3 sono un buon inizio. Aspettati da 5 a 10 token al secondo, adatti a risposte brevi e compiti semplici.
Telefoni con 8 GB di RAM: il compromesso migliore. Qwen 3 1.5B o Phi-4 Mini danno risposte nettamente migliori. Da 10 a 20 token al secondo sugli Snapdragon recenti.
Telefoni con 12 GB di RAM o più: puoi usare modelli 7B come Llama 3.2 7B o Qwen 3 4B. In molti compiti si avvicinano al primo ChatGPT. Da 15 a 30 token al secondo su Snapdragon 8 Gen 3.
La quantizzazione conta. Un modello quantizzato Q4_K_M usa circa metà della memoria della versione completa, con una perdita di qualità minima. Sul telefono scegli sempre Q4 o Q5.
Se hai già dei modelli, puoi importare i tuoi file .gguf dalla memoria del dispositivo.
Come funziona l’IA in locale sul telefono
Con l’IA in locale, i pesi del modello vengono caricati nella RAM del telefono e i calcoli girano sul tuo processore. Nessun server è coinvolto. Dopo aver scaricato un modello da Hugging Face, tutto avviene sul tuo dispositivo.
Off Grid usa llama.cpp, lo stesso motore della maggior parte dell’IA locale su computer. È compilato per ARM64 e sfrutta l’accelerazione disponibile sul telefono: la NPU di Qualcomm tramite QNN, la GPU Adreno tramite OpenCL o la CPU con le istruzioni ARM NEON.
Le tue conversazioni, i documenti e le immagini quindi non toccano mai la rete. Puoi verificarlo attivando la modalità aereo: tutto continua a funzionare.
Accelerazione hardware
Off Grid riconosce l’hardware e sceglie da solo la strada più veloce:
Snapdragon 8 Gen 1 o successivi con QNN: la NPU dedicata è molto più veloce ed efficiente di CPU e GPU. Con uno Snapdragon 8 Gen 2 o Gen 3 è la strada più veloce. Off Grid usa QNN automaticamente quando è disponibile.
GPU Adreno tramite OpenCL: disponibile sulla maggior parte dei telefoni Snapdragon. Più veloce della sola CPU, una buona soluzione per gli Snapdragon più vecchi.
Solo CPU: funziona ovunque. Più lenta, ma va bene per i modelli piccoli.
Il trucco della cache KV che triplica la velocità
È il guadagno di prestazioni più grande, e quasi nessuno lo conosce. La cache KV conserva il contesto della conversazione. Di default usa f16 (virgola mobile a 16 bit). Nelle impostazioni di Off Grid puoi passare a q4_0 (quantizzazione a 4 bit).
Passare da f16 a q4_0 triplica circa la velocità, con un impatto minimo sulla qualità per la maggior parte dei modelli. L’app te lo suggerisce dopo la prima risposta.
La memoria, il vero limite
Il telefono ha 8 GB di RAM, ma il sistema ne usa da 3 a 4. Per l’IA ti restano circa 4 GB.
Regola indicativa: dimensione del file del modello × 1,5 = RAM necessaria durante l’uso (il resto serve alla cache KV e ai calcoli intermedi). Un modello da 4 GB richiede quindi circa 6 GB di RAM libera.
Off Grid controlla la RAM disponibile prima di ogni caricamento e ti avvisa se un modello non ci sta. Così eviti la chiusura improvvisa che avviene quando il sistema termina un’app che usa troppa memoria. Vedi un avviso chiaro invece di un’app che si chiude senza motivo.
Perché in locale e non nel cloud
L’IA in locale sul telefono ti libera da tre cose in un colpo solo.
Niente abbonamento. L’IA nel cloud costa da 20 $ al mese in su. L’IA in locale è gratis dopo il download del modello.
Niente internet. I modelli locali funzionano in aereo, in un seminterrato, in un paese con internet limitato. Senza connessione, nessuna interruzione.
Niente dati esposti. Quello che scrivi in un’IA nel cloud resta su un server che non controlli. In locale, le domande sulla salute, i documenti legali, il diario personale e gli appunti di lavoro riservati non lasciano mai il dispositivo. Off Grid è open source: non devi credere a nessuno sulla parola. Leggi il codice tu stesso.
Per iniziare
- Installa Off Grid dal Play Store
- Apri il catalogo e scegli un modello consigliato per la RAM del tuo dispositivo
- Scarica il modello in Wi-Fi (da 80 MB a oltre 4 GB)
- Attiva la modalità aereo per verificare che tutto giri in locale
- Inizia a chattare
La prima risposta è più lenta perché il modello si carica in memoria. Le successive sono più veloci. Nelle impostazioni, passa la cache KV a q4_0 per la velocità migliore.
Cosa arriva dopo
La prossima generazione di Snapdragon di Qualcomm dovrebbe raggiungere 200 token al secondo nell’IA locale. Il Galaxy S26 di Samsung arriva con l’IA integrata sul dispositivo. E le tecniche di ottimizzazione ottengono sempre più qualità da modelli sempre più piccoli.
Off Grid è in sviluppo attivo, con nuove funzioni ogni settimana. Modalità vocale, strumenti, cache KV configurabile e visione sono arrivati tutti nell’ultimo mese. Trovi le ultime versioni su GitHub.
Tra un anno, far girare l’IA in locale sul telefono non sarà più un trucco da esperti. Sarà la norma.