

In questa pagina
Qwen 3.5 è la famiglia di piccoli modelli a pesi aperti più capace che esista oggi. La serie piccola (0.8B, 2B, 4B, 9B) è stata progettata da zero per girare sul dispositivo, non distillata da un modello più grande. Unisce le Gated Delta Networks a una Mixture-of-Experts sparsa, supporta oltre 200 lingue e gestisce una finestra di contesto di 262K. E puoi farla girare in locale sul tuo telefono Android.
Off Grid è un’app gratuita e open source che fa girare Qwen 3.5 e altri modelli GGUF interamente sull’hardware del tuo telefono. Niente cloud. Niente account. Nessun dato lascia il tuo dispositivo.
| Play Store | GitHub |
Quale modello Qwen 3.5 fa per il tuo telefono
Qwen3.5-0.8B (Q4_K_M), circa 500 MB. Va su qualsiasi telefono con almeno 4 GB di RAM. Pensato per il dispositivo. Veloce: 15-25 token al secondo sulla fascia media. Molto capace per le sue dimensioni grazie all’architettura MoE, che attiva solo una parte dei parametri per ogni token.
Qwen3.5-2B (Q4_K_M), circa 1,2 GB. Il punto giusto per i telefoni da 6-8 GB di RAM. Ragiona molto meglio del 0.8B. 10-18 token al secondo sugli Snapdragon recenti. Ottimo per scrivere, programmare e lavorare in più lingue.
Qwen3.5-4B (Q4_K_M), circa 2,5 GB. Servono almeno 8 GB di RAM. Qui Qwen 3.5 diventa davvero impressionante. L’architettura ibrida gli fa rendere molto più di quanto dica il numero di parametri. Ragionamento in più passaggi, analisi dettagliate, generazione di codice.
Qwen3.5-9B (Q4_K_M), circa 5 GB. Servono almeno 12 GB di RAM. Nei benchmark tiene testa a modelli 20 volte più grandi. Se il tuo telefono ha la RAM, è il miglior modello aperto che puoi far girare in locale.
Perché Qwen 3.5 e non altri modelli
Architettura ibrida. Qwen 3.5 Small non è la versione ridotta di un modello grande. Unisce Gated Delta Networks e Mixture-of-Experts e attiva solo i parametri che servono per ogni token. Più intelligenza per byte di RAM rispetto ai modelli densi tradizionali.
Oltre 200 lingue. Il supporto linguistico più ampio tra i modelli aperti di queste dimensioni. Se lavori in italiano, hindi, arabo, giapponese o in qualsiasi lingua diversa dall’inglese, Qwen 3.5 è la scelta migliore sul telefono.
Finestra di contesto di 262K. I piccoli modelli precedenti arrivavano a 8K-32K. Qwen 3.5 Small gestisce 262K token, quindi puoi dargli documenti interi e fare conversazioni lunghe senza che perda il filo.
Modalità ragionamento. Passa dalle risposte rapide al ragionamento passo per passo. La modalità ragionamento mostra il filo del pensiero del modello e dà risultati migliori sui problemi complessi.
Multimodale. Qwen 3.5 capisce in modo nativo testo, immagini e audio. Inquadra qualcosa con la fotocamera e fai la tua domanda.
Prestazioni su hardware reale
| Modello | Snapdragon 8 Gen 3 | Snapdragon 8 Gen 2 | Fascia media |
|---|---|---|---|
| Qwen3.5-0.8B | ~25 tok/s | ~20 tok/s | ~12 tok/s |
| Qwen3.5-2B | ~18 tok/s | ~14 tok/s | ~8 tok/s |
| Qwen3.5-4B | ~12 tok/s | ~10 tok/s | ~5 tok/s |
| Qwen3.5-9B | ~8 tok/s | ~6 tok/s | - |
Imposta la cache KV su q4_0 nelle impostazioni per triplicare più o meno queste velocità.
Come configurare Qwen 3.5 in Off Grid
- Installa Off Grid dal Play Store
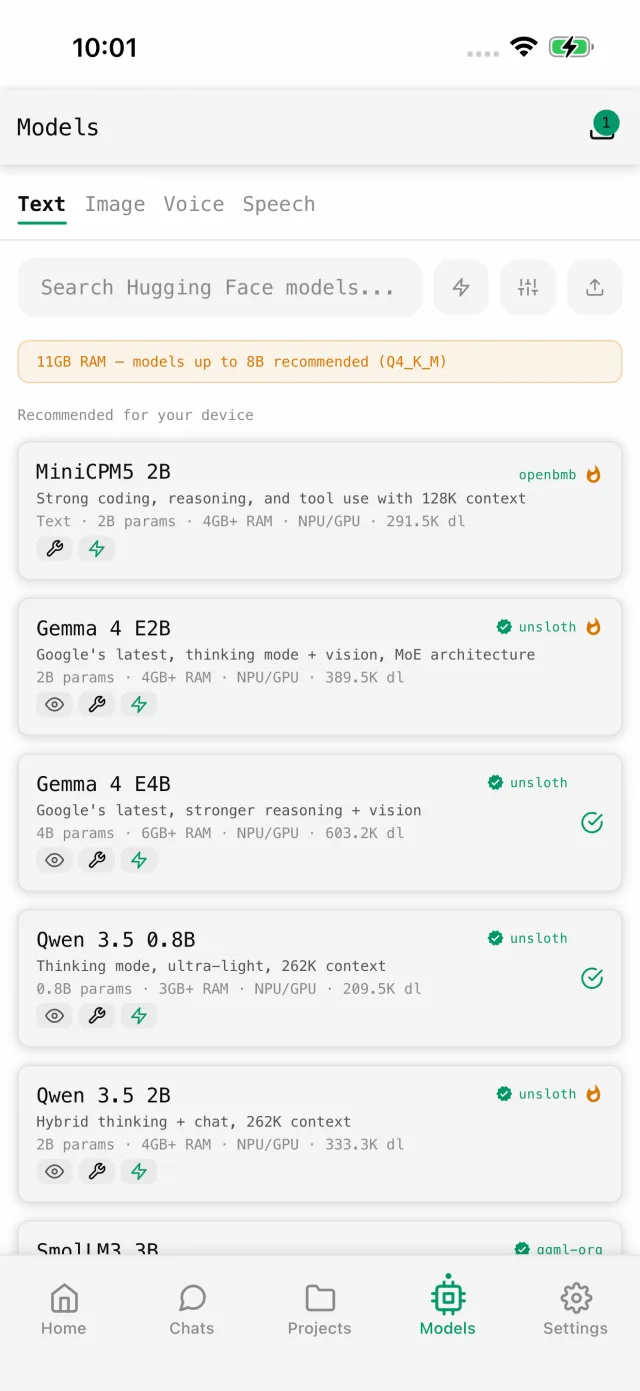
- Apri il catalogo dei modelli: le varianti di Qwen 3.5 sono tra i consigliati
- Scegli la dimensione adatta alla tua RAM
- Scaricala con il Wi-Fi
- Inizia a chattare
Off Grid usa da solo l’accelerazione NPU con QNN su Snapdragon 8 Gen 1 e successivi, la GPU Adreno tramite OpenCL sui chip più vecchi e la CPU su tutto il resto.
Privacy
Ogni risposta di Qwen 3.5 viene calcolata sul processore del tuo telefono. Dopo il primo download, Off Grid non fa nessuna richiesta di rete. Attiva la modalità aereo e verifica. Funziona tutto.
Nessun account. Open source.
Off Grid genera anche immagini, capisce le foto, trascrive la voce, usa strumenti e analizza documenti, tutto sul dispositivo. Le ultime versioni sono su GitHub.