

このページの内容
あなたの Android スマホの GPU は、2018年のほとんどのノートPCより高性能です。最新の Snapdragon チップには AI 専用のアクセラレーターが載っていますが、月20ドル払って他人のサーバーで AI を使っている間、それはずっと眠ったままです。それが変わりつつあります。
Off Grid は、AI モデルを Android スマホ上でローカルに動かす無料のオープンソースアプリです。最初にモデルをダウンロードしたあとはインターネット不要。アカウントも不要。データが端末の外に出ることはありません。このガイドでは、設定方法、使うべきモデル、そしてあなたの端末で期待できる性能を説明します。
| Play ストア | GitHub |
必要なもの
最低条件: メモリ 6GB と ARM64 プロセッサー(ここ4〜5年のスマホならほぼ対応)。80MB ほどの小さなモデルから始められます。
推奨: メモリ 8GB 以上、Snapdragon 8 Gen 2 以降。30億〜70億パラメーターのモデルが動き、本当に役立つ回答が得られます。
クラウド AI との違い: ChatGPT や Claude は、データセンターの GPU で数千億パラメーターのモデルを動かしています。スマホでローカルに動くのは、もっと小さなモデル(10億〜70億パラメーター)です。複雑な推論は苦手ですが、ちょっとした質問、要約、下書き、文書の分析といった日常の用途なら驚くほど使えます。
Off Grid でできること
Off Grid はただのテキストチャットボットではありません。6つの AI 機能をひとつのアプリにまとめ、すべて端末上で動かします。
 チャットの例(iPhone) |
 画像生成(iPhone で表示) |
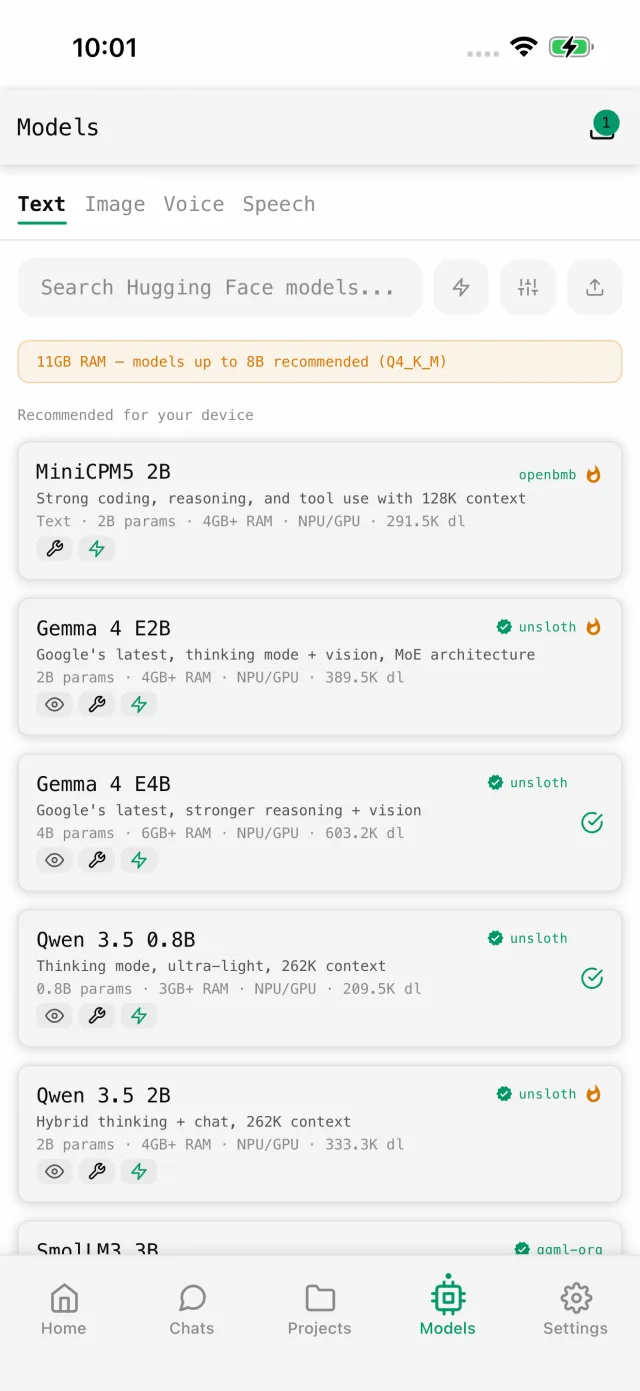 利用できるモデル(iPhone) |
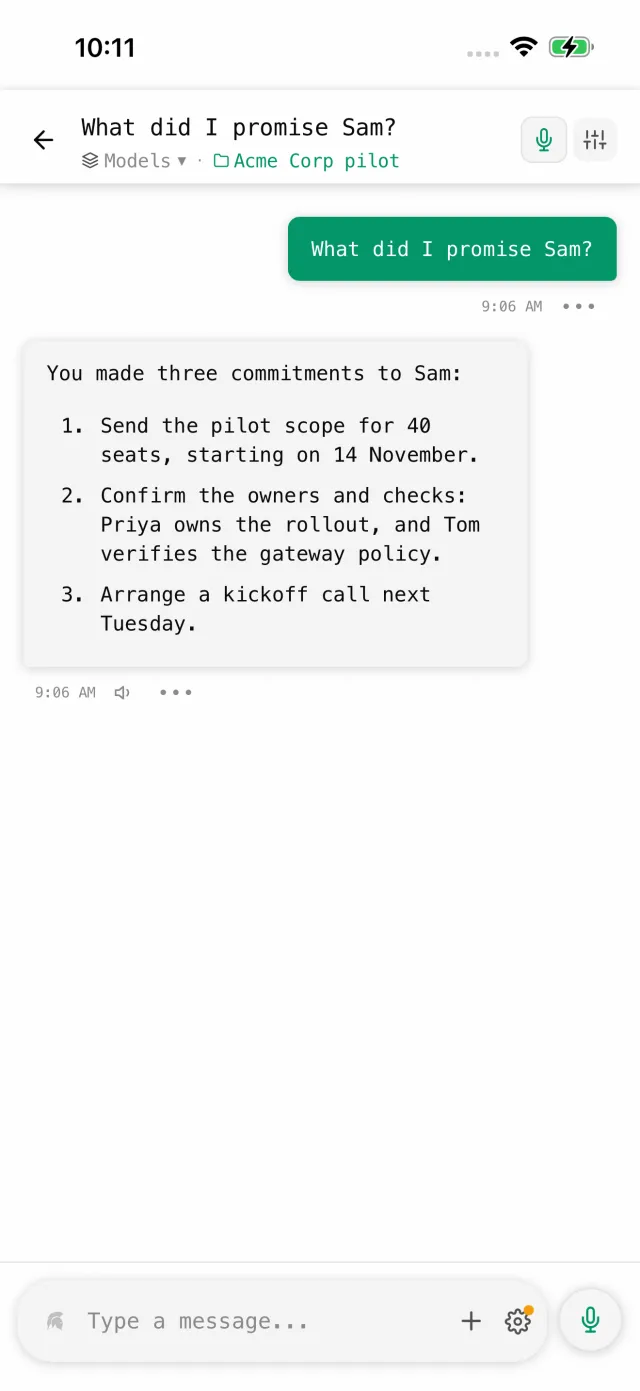 プロジェクトの文書(iPhone) |
テキスト生成。 Qwen 3、Llama 3.2、Gemma 3、Phi-4、そのほか GGUF 形式のモデルならなんでも。回答は一文字ずつ表示され、Markdown にも対応。ハイエンド機で毎秒15〜30トークン、ミドルレンジで毎秒5〜15トークンです。
画像生成。 Stable Diffusion をローカルで、リアルタイムのプレビュー付きで。Snapdragon では NPU で高速化(1枚あたり5〜10秒)。Absolute Reality、DreamShaper、Anything V5 など20以上のモデルがあります。
画像認識。 カメラを向けるか画像を添付して、質問するだけ。SmolVLM や Qwen3-VL はハイエンド機で約7秒で答えます。
音声の文字起こし。 Whisper が声をローカルで文字にします。長押しで録音し、話している間に文字が出てきます。音声がスマホの外に出ることはありません。
ツール。 関数呼び出しに対応したモデルは、内蔵ツール(Web 検索、電卓、日付と時刻、端末情報)を使えます。モデルが自動でツールを組み合わせ、無限ループを防ぐ仕組みもあります。
文書の分析。 PDF、コードファイル、CSV などを会話に添付できます。
どのモデルを使うか
Off Grid のモデル一覧は端末のメモリで絞り込まれるので、スマホで動かないモデルをダウンロードしてしまうことはありません。実機で動く目安はこちらです。
メモリ 6GB のスマホ: 10億〜20億パラメーターのモデルにしましょう。Qwen 3 0.6B か SmolLM3 がおすすめです。速度は毎秒5〜10トークンほどで、短い回答や簡単な作業に向いています。
メモリ 8GB のスマホ: いちばんバランスが良い構成です。Qwen 3 1.5B や Phi-4 Mini で、回答の質がはっきり上がります。最新の Snapdragon で毎秒10〜20トークン。
メモリ 12GB 以上のスマホ: Llama 3.2 7B や Qwen 3 4B のような 7B クラスのモデルが動きます。多くの作業で初期の ChatGPT に近い質です。Snapdragon 8 Gen 3 で毎秒15〜30トークン。
量子化は重要です。 Q4_K_M で量子化されたモデルは、フル精度版の約半分のメモリで動き、質の低下はごくわずかです。スマホでは必ず Q4 か Q5 を選びましょう。
すでにモデルを持っているなら、端末のストレージから自分の .gguf ファイルを読み込むこともできます。
スマホでローカル AI が動く仕組み
ローカルで AI を動かすと、モデルの重みがスマホのメモリに読み込まれ、計算はあなたのプロセッサーで行われます。サーバーは一切関わりません。Hugging Face からモデルをダウンロードしたあとは、すべての計算が端末の中で完結します。
Off Grid の中では llama.cpp が動いています。PC 向けのローカル AI の多くを支えているのと同じエンジンです。ARM64 向けにビルドされ、スマホが持つ高速化の手段を使います。QNN 経由の Qualcomm の NPU、OpenCL 経由の Adreno GPU、または ARM NEON 命令を使う CPU です。
つまり、あなたの会話も文書も画像も、ネットワークに触れることはありません。機内モードをオンにして試してみてください。すべてそのまま動きます。
ハードウェアによる高速化
Off Grid はハードウェアを自動で判別し、いちばん速い方法を選びます。
QNN を使う Snapdragon 8 Gen 1 以降: 専用の NPU は CPU や GPU よりずっと速く、電力効率も高いです。Snapdragon 8 Gen 2 や Gen 3 なら、これが最速です。使える場合、Off Grid は自動で QNN を使います。
OpenCL を使う Adreno GPU: ほとんどの Snapdragon スマホで使えます。CPU だけより速く、古めの Snapdragon 機に向いています。
CPU のみ: どの機種でも動きます。遅めですが、小さなモデルなら十分使えます。
速度が3倍になる KV キャッシュの設定
多くの人が見落としている、いちばん大きな高速化のポイントです。KV キャッシュは会話の文脈を保存する仕組みで、初期設定では f16(16ビット浮動小数点)を使います。Off Grid の設定で q4_0(4ビット量子化)に切り替えられます。
f16 から q4_0 に変えると、推論速度はおよそ3倍になり、ほとんどのモデルで質への影響はごくわずかです。最初の回答のあと、アプリがこの設定をすすめてくれます。
メモリこそが本当の制約
スマホにメモリが 8GB あっても、OS が 3〜4GB を使います。AI に使えるのは実質 4GB ほどです。
目安の計算式:モデルのファイルサイズ × 1.5 = 実行時に必要なメモリ(増えた分は KV キャッシュと途中の計算に使われます)。4GB のモデルなら、空きメモリが約 6GB 必要です。
Off Grid はモデルを読み込む前に空きメモリを確認し、足りない場合は警告します。メモリを使いすぎたアプリを OS が強制終了して、何も言わずに落ちることを防げます。突然アプリが閉じる代わりに、わかりやすい警告が表示されます。
クラウドではなくローカルを選ぶ理由
スマホでローカル AI を動かせば、3つの依存から一度に解放されます。
サブスク不要。 クラウド AI は月20ドルから。ローカル AI は、一度モデルをダウンロードすれば無料です。
ネット不要。 ローカルモデルは飛行機の中でも、地下でも、ネットが制限された国でも動きます。つながらなくても止まりません。
データが漏れない。 クラウド AI に入力した内容は、あなたが管理できないサーバーに保存されます。ローカルなら、健康の相談、法律の書類、個人的な日記、社外秘の仕事のメモが端末の外に出ることはありません。Off Grid はオープンソースなので、誰かのプライバシーの約束を信じる必要はありません。コードを自分で確かめられます。
はじめ方
- Play ストアから Off Grid をインストール
- モデル一覧を開き、端末のメモリに合ったおすすめモデルを選ぶ
- Wi-Fi でモデルをダウンロード(80MB〜4GB 以上)
- 機内モードをオンにして、ローカルで動いていることを確かめる
- チャットを始める
最初の回答は、モデルをメモリに読み込むので少し時間がかかります。2回目以降は速くなります。設定で KV キャッシュを q4_0 にすると最速です。
これから
Qualcomm の次世代 Snapdragon は、ローカル AI で毎秒200トークンに届くと見込まれています。Samsung の Galaxy S26 は端末上で動く AI を内蔵しています。モデルの最適化も進み、小さなモデルでも質がどんどん上がっています。
Off Grid は活発に開発が続いていて、毎週新しい機能が出ています。音声モード、ツール、KV キャッシュの設定、画像認識は、どれもこの1か月で追加されました。最新版は GitHub で確認できます。
1年後には、スマホでローカル AI を動かすのは一部の詳しい人の技ではなく、当たり前になっているはずです。