

Op deze pagina
Je Android-telefoon heeft een snellere GPU dan de meeste laptops uit 2018. Moderne Snapdragon-chips hebben eigen AI-versnellers die stilliggen terwijl jij $20 per maand betaalt om AI op de server van iemand anders te gebruiken. Dat verandert.
Off Grid is een gratis open-source-app die AI-modellen lokaal op je Android-telefoon draait. Na de eerste download van een model heb je geen internet meer nodig. Geen account. Geen gegevens die je toestel verlaten. Deze gids laat zien hoe je het instelt, welke modellen je kiest en welke snelheid je op jouw hardware mag verwachten.
| Play Store | GitHub |
Wat je nodig hebt
Minimaal: 6 GB RAM en een ARM64-processor (elke telefoon van de afgelopen vier tot vijf jaar). Je kunt beginnen met modellen van maar 80 MB.
Aanbevolen: 8 GB RAM of meer, Snapdragon 8 Gen 2 of nieuwer. Dan draai je modellen van 3 tot 7 miljard parameters die echt bruikbare antwoorden geven.
Het verschil met AI in de cloud: diensten als ChatGPT en Claude draaien modellen met honderden miljarden parameters op GPU’s in datacenters. Op je telefoon draaien kleinere modellen (1 tot 7 miljard parameters). Bij complexe redeneringen zijn ze minder sterk, maar voor dagelijkse dingen (snelle vragen, samenvattingen, concepten en documenten analyseren) zijn ze verrassend goed.
Wat Off Grid kan
Off Grid is meer dan een tekstchatbot. De app combineert zes AI-functies in één app, allemaal op je toestel:
 Voorbeeldchat (iPhone) |
 Afbeeldingen maken (op iPhone) |
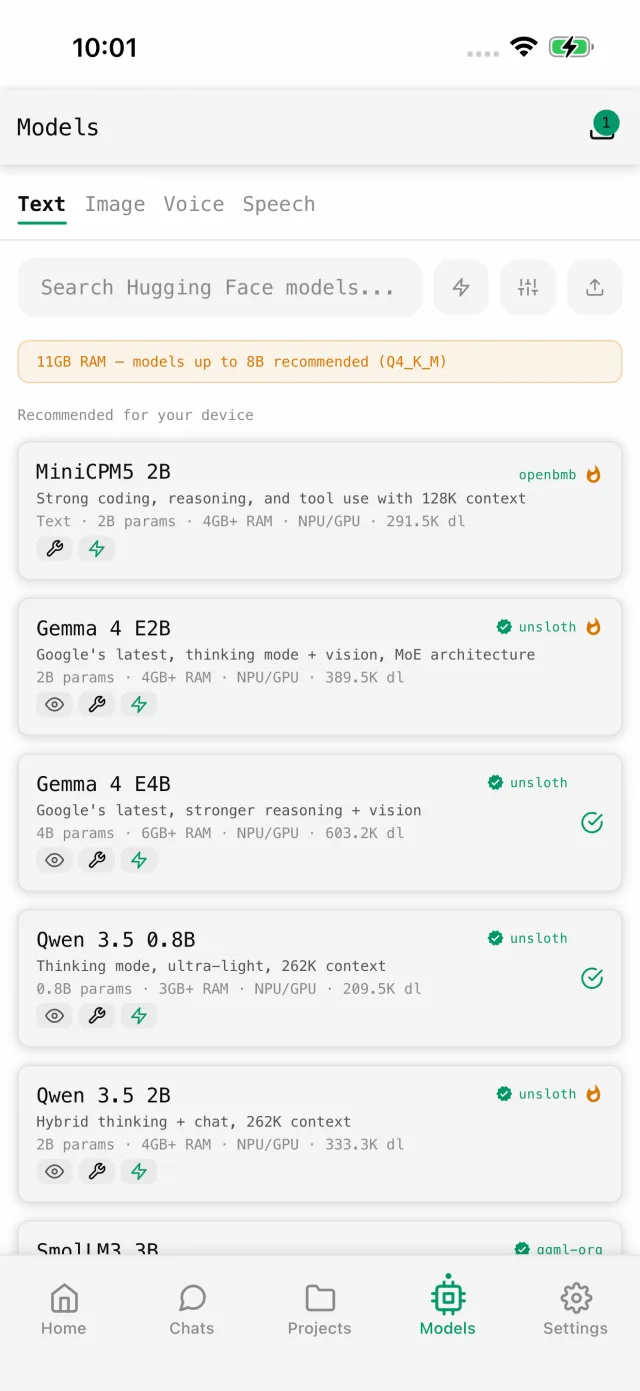 Beschikbare modellen (iPhone) |
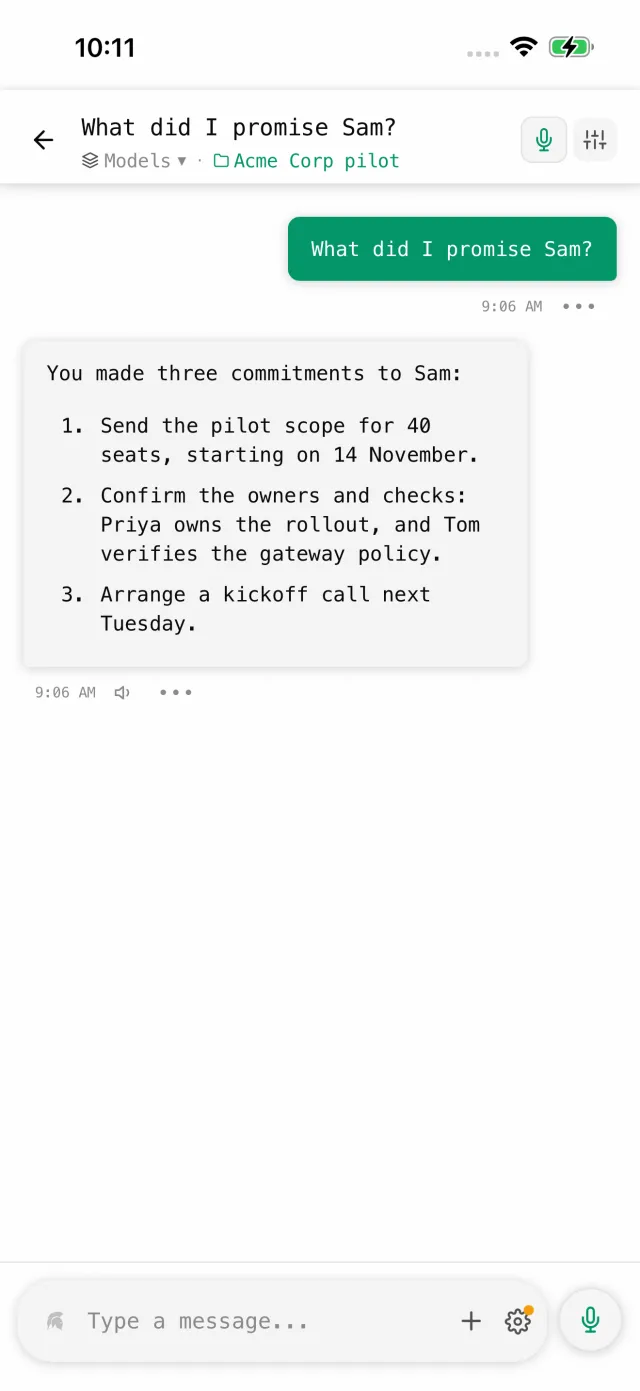 Projectdocumenten (iPhone) |
Tekst genereren. Qwen 3, Llama 3.2, Gemma 3, Phi-4 of elk ander GGUF-model. Antwoorden verschijnen woord voor woord, met markdown. 15 tot 30 tokens per seconde op topmodellen, 5 tot 15 in het middensegment.
Afbeeldingen maken. Stable Diffusion lokaal, met live voorbeeld. Op Snapdragon versneld door de NPU (5 tot 10 seconden per afbeelding). Meer dan 20 modellen, waaronder Absolute Reality, DreamShaper en Anything V5.
Beeldherkenning. Richt je camera op iets of voeg een afbeelding toe en stel er vragen over. SmolVLM en Qwen3-VL doen er op topmodellen zo’n 7 seconden over.
Spraak naar tekst. Whisper zet je stem lokaal om in tekst. Houd ingedrukt om op te nemen, de tekst verschijnt terwijl je praat. Geen audio verlaat je telefoon.
Tools. Modellen met function calling gebruiken ingebouwde tools: zoeken op het web, rekenmachine, datum en tijd, toestelinfo. Het model koppelt ze automatisch aan elkaar, met bescherming tegen eindeloze lussen.
Documenten analyseren. Voeg pdf’s, codebestanden, csv’s en meer toe aan je gesprekken.
Welke modellen je kiest
De modelbibliotheek van Off Grid filtert op het RAM van je toestel, zodat je nooit iets downloadt wat je telefoon niet aankan. Dit werkt op echte hardware:
Telefoons met 6 GB RAM: houd het bij modellen van 1 tot 2 miljard parameters. Qwen 3 0.6B of SmolLM3 zijn een goed begin. Reken op 5 tot 10 tokens per seconde, prima voor korte antwoorden en simpele taken.
Telefoons met 8 GB RAM: de beste balans. Qwen 3 1.5B of Phi-4 Mini geven merkbaar betere antwoorden. 10 tot 20 tokens per seconde op recente Snapdragon-chips.
Telefoons met 12 GB RAM of meer: je kunt 7B-modellen draaien zoals Llama 3.2 7B of Qwen 3 4B. Voor veel taken komen ze in de buurt van de eerste ChatGPT. 15 tot 30 tokens per seconde op de Snapdragon 8 Gen 3.
Kwantisatie telt. Een model met Q4_K_M-kwantisatie gebruikt ongeveer de helft van het geheugen van de volledige versie, met nauwelijks kwaliteitsverlies. Kies op een telefoon altijd Q4 of Q5.
Heb je al modellen gedownload, dan kun je je eigen .gguf-bestanden importeren vanuit de opslag van je toestel.
Zo werkt lokale AI op je telefoon
Bij lokale AI worden de gewichten van het model in het RAM van je telefoon geladen en draait de berekening op je processor. Er komt geen server aan te pas. Nadat je een model van Hugging Face hebt gedownload, gebeurt elke berekening op je toestel.
Off Grid gebruikt llama.cpp, dezelfde engine achter de meeste lokale AI op computers. Die is gebouwd voor ARM64 en gebruikt elke versnelling die je telefoon heeft: de NPU van Qualcomm via QNN, de Adreno-GPU via OpenCL of de CPU met ARM NEON-instructies.
Je gesprekken, documenten en afbeeldingen raken dus nooit een netwerk. Zet je vliegtuigmodus aan om het te controleren: alles blijft werken.
Hardwareversnelling
Off Grid herkent je hardware en kiest automatisch de snelste route:
Snapdragon 8 Gen 1 of nieuwer met QNN: de eigen NPU is een stuk sneller en zuiniger dan de CPU of GPU. Met een Snapdragon 8 Gen 2 of Gen 3 is dit de snelste route. Off Grid gebruikt QNN automatisch als het beschikbaar is.
Adreno-GPU via OpenCL: beschikbaar op de meeste Snapdragon-telefoons. Sneller dan alleen de CPU, een goede optie voor oudere Snapdragon-toestellen.
Alleen CPU: werkt overal. Trager, maar bruikbaar voor kleinere modellen.
De KV-cache-truc die je snelheid verdrievoudigt
Dit is de grootste snelheidswinst, en de meeste mensen zien hem over het hoofd. De KV-cache bewaart de context van je gesprek. Standaard gebruikt hij f16 (16-bit drijvende komma). In de instellingen van Off Grid kun je overschakelen naar q4_0 (4-bit kwantisatie).
Van f16 naar q4_0 gaan verdrievoudigt de snelheid ongeveer, bij de meeste modellen met nauwelijks kwaliteitsverlies. De app stelt het voor na je eerste antwoord.
Geheugen, de echte grens
Je telefoon heeft 8 GB RAM, maar het systeem gebruikt daar 3 tot 4 GB van. Voor AI houd je zo’n 4 GB over.
Vuistregel: bestandsgrootte van het model × 1,5 = RAM die het tijdens gebruik nodig heeft (de rest is voor de KV-cache en tussenresultaten). Een model van 4 GB heeft dus zo’n 6 GB vrij RAM nodig.
Off Grid controleert het vrije RAM voor elke keer laden en waarschuwt je als een model niet past. Zo voorkom je dat de app ineens verdwijnt omdat het systeem hem afsluit vanwege te veel geheugengebruik. Je krijgt een duidelijke melding in plaats van een app die zomaar sluit.
Waarom lokaal in plaats van in de cloud
Lokale AI op je telefoon maakt je in één keer van drie dingen los.
Geen abonnement. AI in de cloud kost $20 per maand of meer. Lokale AI is gratis na de eenmalige download van het model.
Geen internet. Lokale modellen werken in het vliegtuig, in een kelder of in een land met beperkt internet. Geen verbinding betekent geen onderbreking.
Geen gegevens naar buiten. Wat je in een AI in de cloud typt, staat op een server die jij niet beheert. Lokaal blijven je medische vragen, juridische documenten, dagboekaantekeningen en vertrouwelijke werknotities op je toestel. Off Grid is open source, dus je hoeft niemand op zijn woord te geloven. Lees de code zelf.
Aan de slag
- Installeer Off Grid uit de Play Store
- Open de modelbibliotheek en kies een aanbevolen model voor het RAM van je toestel
- Download het model via wifi (van 80 MB tot meer dan 4 GB)
- Zet de vliegtuigmodus aan om te controleren dat alles lokaal draait
- Begin met chatten
Het eerste antwoord duurt langer omdat het model in het geheugen wordt geladen. Daarna gaat het sneller. Zet in de instellingen de KV-cache op q4_0 voor de beste snelheid.
Wat er komt
De volgende generatie Snapdragon van Qualcomm haalt naar verwachting 200 tokens per seconde voor lokale AI. De Galaxy S26 van Samsung komt met ingebouwde AI op het toestel. En slimmere optimalisaties halen steeds meer kwaliteit uit steeds kleinere modellen.
Off Grid wordt actief ontwikkeld, met elke week nieuwe functies. Spraakmodus, tools, een instelbare KV-cache en beeldherkenning kwamen allemaal de afgelopen maand. De nieuwste versies vind je op GitHub.
Over een jaar is lokale AI op je telefoon geen truc meer voor kenners. Het is dan gewoon de standaard.