

Na tej stronie
Twój telefon z Androidem ma mocniejszy GPU niż większość laptopów z 2018 roku. Nowe układy Snapdragon mają osobne akceleratory AI, które stoją bezczynnie, a Ty płacisz 20 $ miesięcznie za AI działającą na cudzym serwerze. To się zmienia.
Off Grid to darmowa aplikacja open source, która uruchamia modele AI lokalnie na Twoim telefonie z Androidem. Po pierwszym pobraniu modelu internet nie jest potrzebny. Bez konta. Żadne dane nie opuszczają urządzenia. Z tego poradnika dowiesz się, jak to skonfigurować, jakie modele wybrać i jakiej wydajności spodziewać się na swoim sprzęcie.
| Sklep Play | GitHub |
Czego potrzebujesz
Minimum: 6 GB RAM i procesor ARM64 (każdy telefon z ostatnich czterech, pięciu lat). Możesz zacząć od modeli ważących zaledwie 80 MB.
Zalecane: 8 GB RAM lub więcej, Snapdragon 8 Gen 2 lub nowszy. Wtedy działają modele z 3 do 7 miliardami parametrów, które dają naprawdę przydatne odpowiedzi.
Różnica w porównaniu z AI w chmurze: ChatGPT czy Claude korzystają z modeli z setkami miliardów parametrów na GPU w centrach danych. Na telefonie działają mniejsze modele (od 1 do 7 miliardów parametrów). Słabiej radzą sobie ze złożonym rozumowaniem, ale w codziennych zadaniach (szybkie pytania, streszczenia, szkice, analiza dokumentów) są zaskakująco dobre.
Co potrafi Off Grid
Off Grid to coś więcej niż czatbot tekstowy. Łączy sześć funkcji AI w jednej aplikacji, wszystkie na Twoim urządzeniu:
 Przykładowy czat (iPhone) |
 Generowanie obrazów (na iPhonie) |
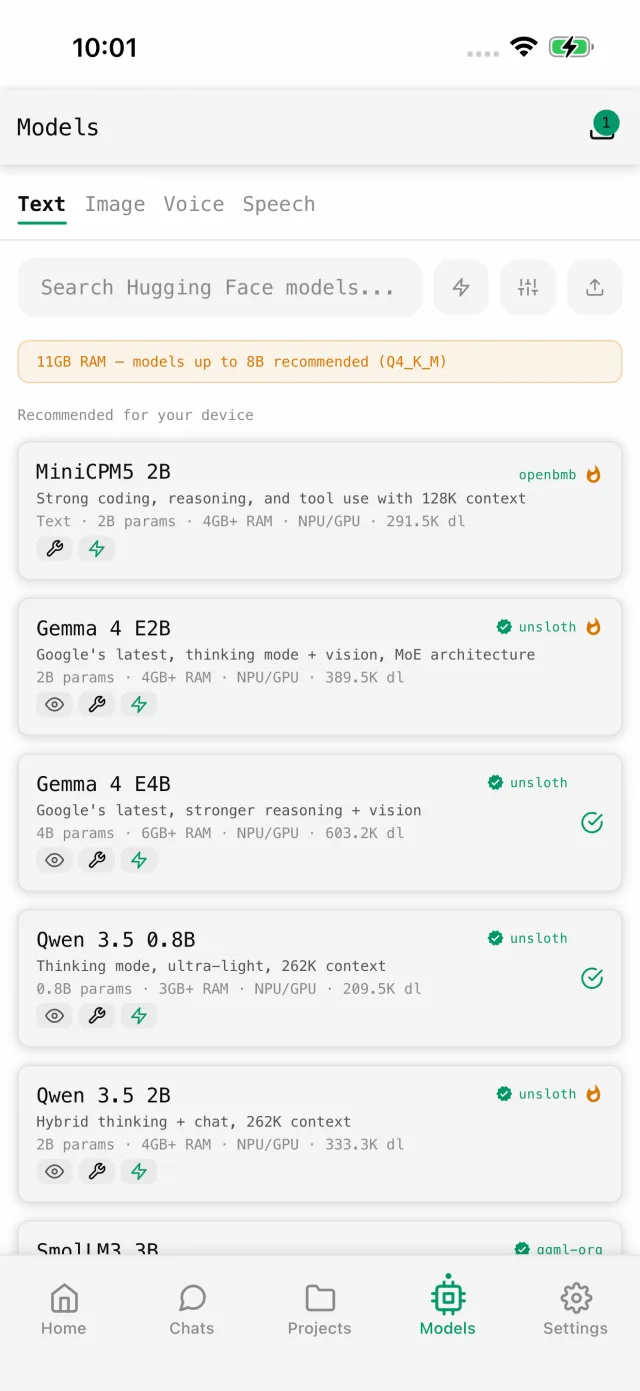 Dostępne modele (iPhone) |
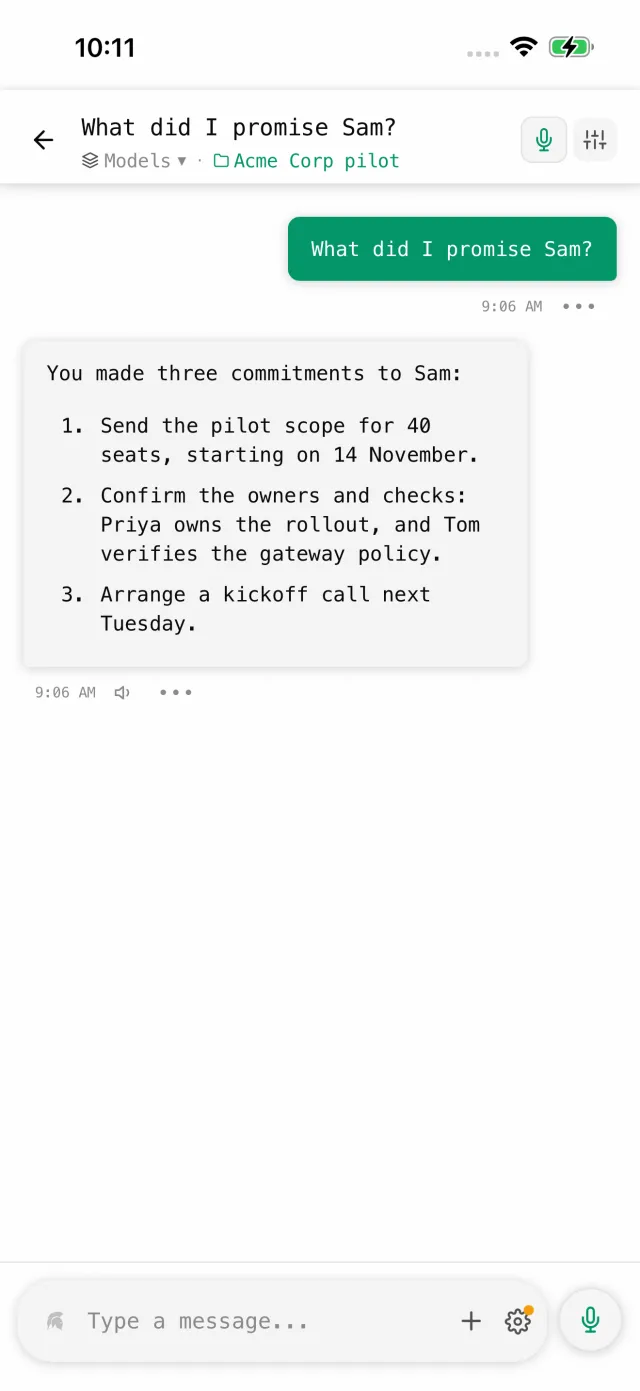 Dokumenty projektu (iPhone) |
Generowanie tekstu. Qwen 3, Llama 3.2, Gemma 3, Phi-4 lub dowolny model GGUF. Odpowiedzi pojawiają się słowo po słowie, z obsługą Markdown. 15 do 30 tokenów na sekundę na flagowcach, 5 do 15 na średniej półce.
Generowanie obrazów. Lokalny Stable Diffusion z podglądem na żywo. Na Snapdragonie przyspieszany przez NPU (5 do 10 sekund na obraz). Ponad 20 modeli, m.in. Absolute Reality, DreamShaper i Anything V5.
Rozpoznawanie obrazu. Skieruj aparat na coś albo dołącz zdjęcie i zadaj pytanie. SmolVLM i Qwen3-VL odpowiadają w około 7 sekund na flagowcach.
Zamiana mowy na tekst. Lokalny Whisper zamienia głos na tekst. Przytrzymaj, aby nagrywać, a tekst pojawia się w trakcie mówienia. Dźwięk nigdy nie opuszcza telefonu.
Narzędzia. Modele obsługujące wywoływanie funkcji korzystają z wbudowanych narzędzi: wyszukiwania w sieci, kalkulatora, daty i godziny, informacji o urządzeniu. Model sam łączy je w łańcuch, z zabezpieczeniem przed niekończącymi się pętlami.
Analiza dokumentów. Dołączaj do rozmów pliki PDF, kod, CSV i inne.
Jakie modele wybrać
Katalog modeli w Off Grid filtruje je według pamięci RAM urządzenia, więc nigdy nie pobierzesz czegoś, czego telefon nie uciągnie. Oto co działa na prawdziwym sprzęcie:
Telefony z 6 GB RAM: trzymaj się modeli z 1 do 2 miliardami parametrów. Qwen 3 0.6B albo SmolLM3 to dobry początek. Licz na 5 do 10 tokenów na sekundę, wystarczy do krótkich odpowiedzi i prostych zadań.
Telefony z 8 GB RAM: najlepszy kompromis. Qwen 3 1.5B albo Phi-4 Mini dają wyraźnie lepsze odpowiedzi. 10 do 20 tokenów na sekundę na nowych Snapdragonach.
Telefony z 12 GB RAM i więcej: możesz uruchamiać modele 7B, np. Llama 3.2 7B albo Qwen 3 4B. W wielu zadaniach zbliżają się do wczesnego ChatGPT. 15 do 30 tokenów na sekundę na Snapdragonie 8 Gen 3.
Kwantyzacja ma znaczenie. Model w kwantyzacji Q4_K_M zajmuje mniej więcej połowę pamięci pełnej wersji, przy minimalnej utracie jakości. Na telefonie zawsze wybieraj Q4 lub Q5.
Jeśli masz już pobrane modele, możesz zaimportować własne pliki .gguf z pamięci urządzenia.
Jak lokalna AI działa na telefonie
Przy lokalnej AI wagi modelu ładują się do pamięci RAM telefonu, a obliczenia działają na Twoim procesorze. Żaden serwer nie bierze w tym udziału. Po pobraniu modelu z Hugging Face wszystko dzieje się na urządzeniu.
Off Grid korzysta z llama.cpp, tego samego silnika, który napędza większość lokalnej AI na komputerach. Jest skompilowany dla ARM64 i wykorzystuje przyspieszenie, jakie oferuje Twój telefon: NPU Qualcomma przez QNN, GPU Adreno przez OpenCL albo procesor z instrukcjami ARM NEON.
Twoje rozmowy, dokumenty i obrazy w ogóle nie trafiają do sieci. Sprawdź to, włączając tryb samolotowy. Wszystko działa dalej.
Przyspieszenie sprzętowe
Off Grid sam rozpoznaje sprzęt i wybiera najszybszą drogę:
Snapdragon 8 Gen 1 lub nowszy z QNN: osobny układ NPU jest znacznie szybszy i oszczędniejszy niż CPU czy GPU. Na Snapdragonie 8 Gen 2 lub Gen 3 to najszybsza opcja. Off Grid używa QNN automatycznie, gdy jest dostępne.
GPU Adreno przez OpenCL: dostępne na większości telefonów ze Snapdragonem. Szybsze niż sam procesor, dobre dla starszych Snapdragonów.
Tylko CPU: działa wszędzie. Wolniej, ale przy mniejszych modelach da się z tego korzystać.
Sztuczka z pamięcią KV, która potraja szybkość
To największy zysk wydajności, o którym większość ludzi nie wie. Pamięć podręczna KV przechowuje kontekst rozmowy. Domyślnie używa f16 (16-bitowa liczba zmiennoprzecinkowa). W ustawieniach Off Grid możesz przełączyć ją na q4_0 (kwantyzacja 4-bitowa).
Przejście z f16 na q4_0 mniej więcej potraja szybkość, a przy większości modeli jakość prawie się nie zmienia. Aplikacja sama to podpowiada po pierwszej odpowiedzi.
Pamięć to prawdziwe ograniczenie
Telefon ma 8 GB RAM, ale system zajmuje z tego 3 do 4 GB. Na AI zostaje Ci około 4 GB.
Przybliżony wzór: rozmiar pliku modelu × 1,5 = ile pamięci potrzebuje w działaniu (reszta idzie na pamięć KV i obliczenia pośrednie). Model o wadze 4 GB potrzebuje więc około 6 GB wolnej pamięci.
Off Grid przed każdym załadowaniem sprawdza wolną pamięć i ostrzega, jeśli model się nie zmieści. Dzięki temu aplikacja nie znika nagle, gdy system zamyka ją z powodu zbyt dużego zużycia pamięci. Zamiast tego widzisz zrozumiały komunikat.
Dlaczego lokalnie, a nie w chmurze
Lokalna AI na telefonie uwalnia Cię od trzech rzeczy naraz.
Bez subskrypcji. AI w chmurze kosztuje od 20 $ miesięcznie. Lokalna AI jest darmowa po jednorazowym pobraniu modelu.
Bez internetu. Lokalne modele działają w samolocie, w piwnicy i w krajach z ograniczonym internetem. Brak połączenia to brak przerw.
Bez wycieku danych. To, co wpisujesz do AI w chmurze, trafia na serwer, którego nie kontrolujesz. Lokalnie Twoje pytania o zdrowie, dokumenty prawne, osobisty dziennik i poufne notatki służbowe nigdy nie opuszczają urządzenia. Off Grid ma otwarty kod, więc nie musisz nikomu wierzyć na słowo. Przeczytaj kod sam.
Jak zacząć
- Zainstaluj Off Grid ze Sklepu Play
- Otwórz katalog modeli i wybierz model polecany dla ilości RAM w Twoim urządzeniu
- Pobierz model przez Wi-Fi (od 80 MB do ponad 4 GB)
- Włącz tryb samolotowy, żeby sprawdzić, że wszystko działa lokalnie
- Zacznij rozmawiać
Pierwsza odpowiedź trwa dłużej, bo model ładuje się do pamięci. Kolejne są szybsze. W ustawieniach przełącz pamięć KV na q4_0, a uzyskasz najlepszą szybkość.
Co dalej
Następna generacja Snapdragona od Qualcomma ma osiągać 200 tokenów na sekundę w lokalnej AI. Samsung Galaxy S26 ma wbudowaną AI działającą na urządzeniu. A techniki optymalizacji wyciskają coraz więcej jakości z coraz mniejszych modeli.
Off Grid jest aktywnie rozwijany, nowe funkcje pojawiają się co tydzień. Tryb głosowy, narzędzia, konfigurowalna pamięć KV i rozpoznawanie obrazu doszły w ostatnim miesiącu. Najnowsze wersje znajdziesz na GitHubie.
Za rok uruchamianie AI lokalnie na telefonie nie będzie już sztuczką dla zapaleńców. Będzie standardem.