

Na tej stronie
Qwen 3.5 to obecnie najmocniejsza rodzina małych modeli z otwartymi wagami. Mała seria (0.8B, 2B, 4B, 9B) od początku powstawała z myślą o działaniu na urządzeniu, a nie jako destylat większego modelu. Łączy Gated Delta Networks z rzadką mieszanką ekspertów (MoE), obsługuje ponad 200 języków i okno kontekstu 262K. I możesz ją uruchomić lokalnie na telefonie z Androidem.
Off Grid to darmowa aplikacja open source, która uruchamia Qwen 3.5 i inne modele GGUF w całości na sprzęcie Twojego telefonu. Bez chmury. Bez konta. Żadne dane nie opuszczają urządzenia.
| Sklep Play | GitHub |
Który model Qwen 3.5 pasuje do Twojego telefonu
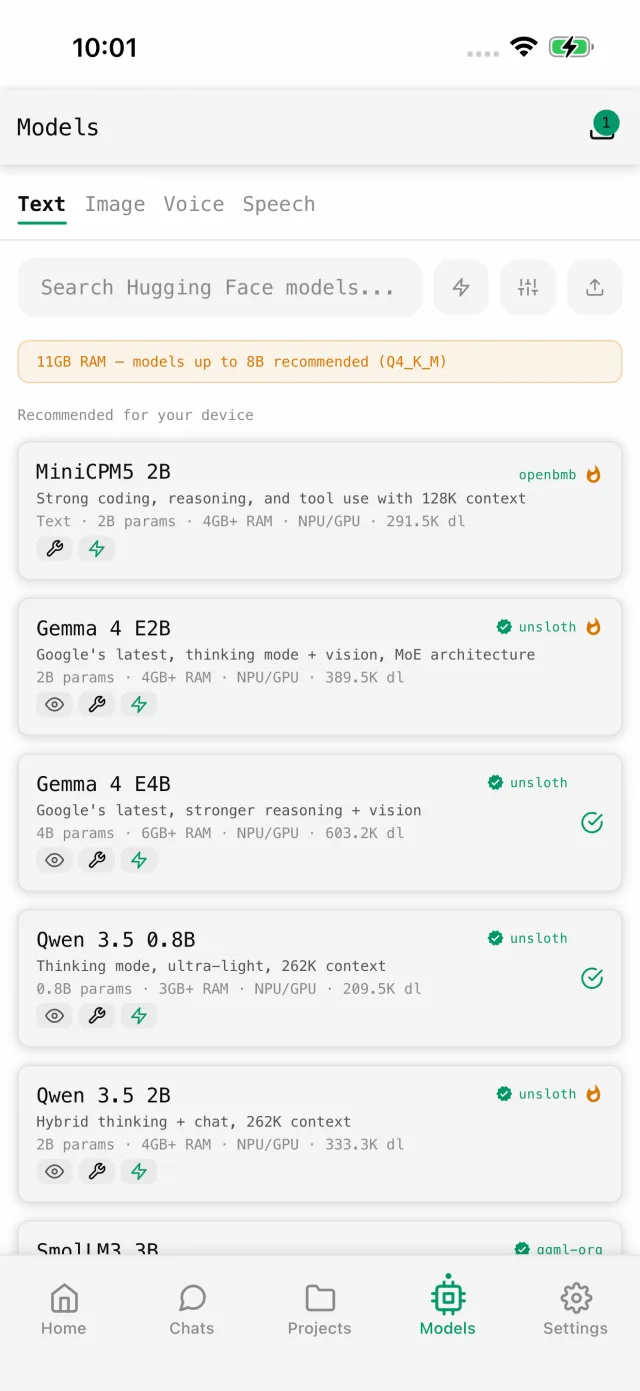
Qwen3.5-0.8B (Q4_K_M), około 500 MB. Zmieści się na każdym telefonie z co najmniej 4 GB RAM. Stworzony z myślą o urządzeniach. Szybki: 15-25 tokenów na sekundę na średniej półce. Zaskakująco dobry jak na swój rozmiar dzięki architekturze MoE, która przy każdym tokenie włącza tylko część parametrów.
Qwen3.5-2B (Q4_K_M), około 1,2 GB. Najlepszy wybór dla telefonów z 6-8 GB RAM. Rozumuje wyraźnie lepiej niż 0.8B. 10-18 tokenów na sekundę na nowszych Snapdragonach. Dobry do pisania, kodu i pracy w wielu językach.
Qwen3.5-4B (Q4_K_M), około 2,5 GB. Wymaga co najmniej 8 GB RAM. Tu Qwen 3.5 naprawdę robi wrażenie. Hybrydowa architektura sprawia, że daje dużo więcej, niż sugeruje liczba parametrów. Rozumowanie w kilku krokach, szczegółowe analizy, pisanie kodu.
Qwen3.5-9B (Q4_K_M), około 5 GB. Wymaga co najmniej 12 GB RAM. W benchmarkach dorównuje modelom 20 razy większym. Jeśli Twój telefon ma tyle pamięci, to najlepszy otwarty model, jaki uruchomisz lokalnie.
Dlaczego Qwen 3.5, a nie inne modele
Hybrydowa architektura. Qwen 3.5 Small to nie pomniejszona wersja dużego modelu. Łączy Gated Delta Networks z mieszanką ekspertów i przy każdym tokenie włącza tylko potrzebne parametry. Więcej inteligencji na każdy bajt RAM niż w klasycznych gęstych modelach.
Ponad 200 języków. Najszersza obsługa języków spośród otwartych modeli tej wielkości. Jeśli pracujesz po polsku, w hindi, po arabsku, po japońsku czy w innym języku niż angielski, Qwen 3.5 to najlepszy wybór na telefon.
Okno kontekstu 262K. Wcześniejsze małe modele kończyły się na 8K-32K. Qwen 3.5 Small obsługuje 262K tokenów, więc możesz dać mu całe dokumenty i prowadzić długie rozmowy bez gubienia wątku.
Tryb myślenia. Przełączaj się między szybkimi odpowiedziami a rozumowaniem krok po kroku. Tryb myślenia pokazuje tok rozumowania modelu i daje lepsze wyniki przy trudnych zadaniach.
Multimodalność. Qwen 3.5 natywnie rozumie tekst, obrazy i dźwięk. Skieruj aparat na coś i zapytaj.
Wydajność na prawdziwym sprzęcie
| Model | Snapdragon 8 Gen 3 | Snapdragon 8 Gen 2 | Średnia półka |
|---|---|---|---|
| Qwen3.5-0.8B | ~25 tok/s | ~20 tok/s | ~12 tok/s |
| Qwen3.5-2B | ~18 tok/s | ~14 tok/s | ~8 tok/s |
| Qwen3.5-4B | ~12 tok/s | ~10 tok/s | ~5 tok/s |
| Qwen3.5-9B | ~8 tok/s | ~6 tok/s | - |
Przestaw w ustawieniach pamięć podręczną KV na q4_0, a te prędkości wzrosną mniej więcej trzykrotnie.
Jak skonfigurować Qwen 3.5 w Off Grid
- Zainstaluj Off Grid ze Sklepu Play
- Otwórz katalog modeli: warianty Qwen 3.5 są w sekcji polecanych
- Wybierz rozmiar pasujący do Twojej pamięci RAM
- Pobierz przez Wi-Fi
- Zacznij rozmawiać
Off Grid sam używa akceleracji NPU przez QNN na Snapdragonie 8 Gen 1 i nowszych, GPU Adreno przez OpenCL na starszych układach i CPU na pozostałych.
Prywatność
Każda odpowiedź Qwen 3.5 jest liczona na procesorze Twojego telefonu. Po pierwszym pobraniu Off Grid nie wysyła ani jednego zapytania do sieci. Włącz tryb samolotowy i sprawdź. Wszystko działa.
Bez konta. Open source.
Off Grid generuje też obrazy, rozumie zdjęcia, zamienia mowę na tekst, używa narzędzi i analizuje dokumenty, wszystko na urządzeniu. Najnowsze wersje są na GitHubie.