

Nesta página
Seu celular Android tem uma GPU mais potente que a maioria dos notebooks de 2018. Os chips Snapdragon modernos têm aceleradores de IA dedicados que ficam parados enquanto você paga US$ 20 por mês para usar IA no servidor de outra pessoa. Isso está mudando.
Off Grid é um app gratuito e de código aberto que roda modelos de IA localmente no seu celular Android. Depois de baixar o modelo pela primeira vez, você não precisa de internet. Sem conta. Nenhum dado sai do seu aparelho. Este guia mostra como configurar, quais modelos usar e qual desempenho esperar no seu hardware.
| Play Store | GitHub |
O que você precisa
Mínimo: 6 GB de RAM e um processador ARM64 (qualquer celular dos últimos quatro ou cinco anos). Dá para começar com modelos de só 80 MB.
Recomendado: 8 GB de RAM ou mais, Snapdragon 8 Gen 2 ou mais novo. Assim você roda modelos de 3 a 7 bilhões de parâmetros, que dão respostas realmente úteis.
A diferença para a IA na nuvem: serviços como ChatGPT e Claude usam modelos com centenas de bilhões de parâmetros em GPUs de data center. No celular rodam modelos menores (de 1 a 7 bilhões de parâmetros). Eles são mais fracos em raciocínios complexos, mas para o dia a dia (perguntas rápidas, resumos, rascunhos e análise de documentos) se saem surpreendentemente bem.
O que o Off Grid faz
O Off Grid não é só um chatbot de texto. Ele reúne seis recursos de IA em um único app, todos no seu aparelho:
 Chat de exemplo (iPhone) |
 Geração de imagens (no iPhone) |
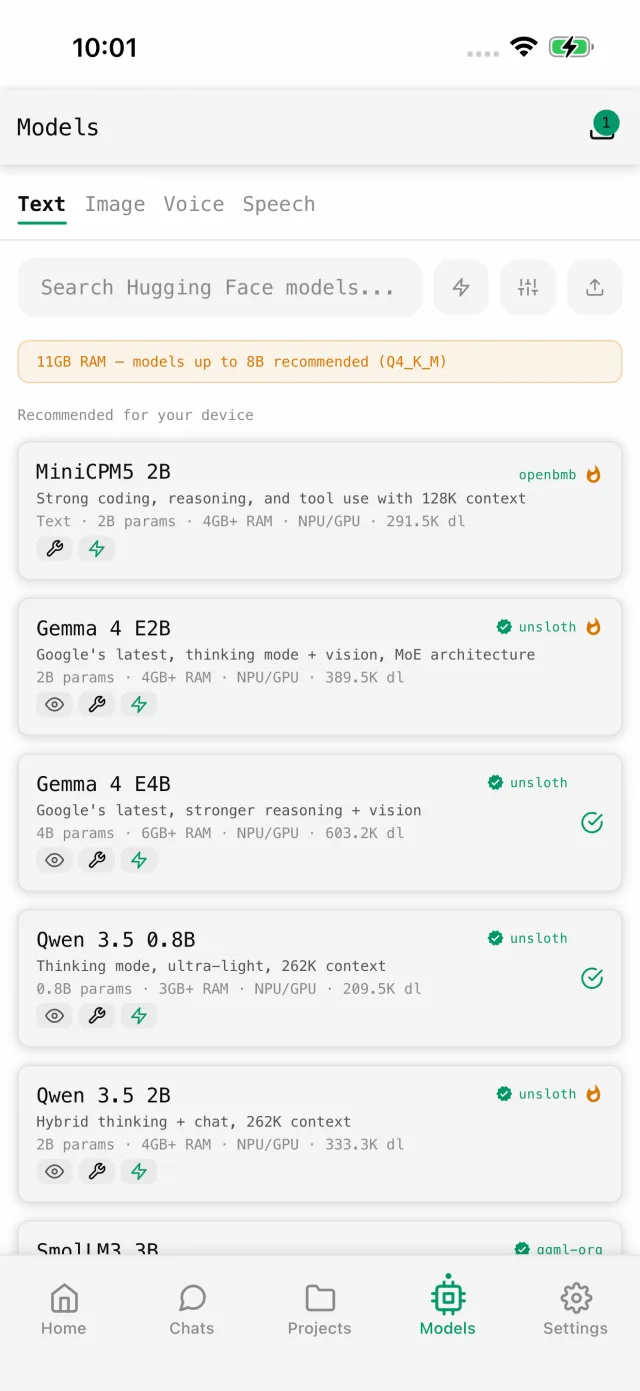 Modelos disponíveis (iPhone) |
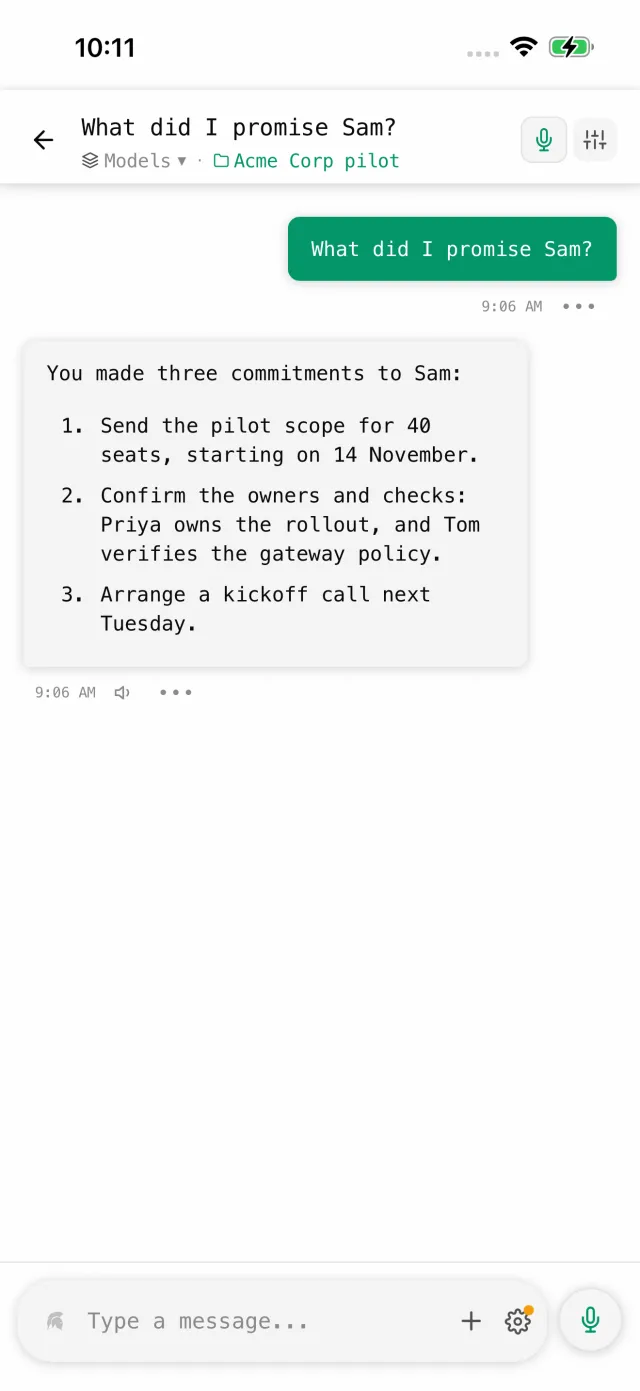 Documentos do projeto (iPhone) |
Geração de texto. Qwen 3, Llama 3.2, Gemma 3, Phi-4 ou qualquer modelo GGUF. As respostas aparecem palavra por palavra, com markdown. De 15 a 30 tokens por segundo nos topos de linha e de 5 a 15 nos intermediários.
Geração de imagens. Stable Diffusion local com prévia em tempo real. Acelerada pela NPU no Snapdragon (de 5 a 10 segundos por imagem). Mais de 20 modelos, como Absolute Reality, DreamShaper e Anything V5.
Visão. Aponte a câmera para algo ou anexe uma imagem e faça perguntas sobre ela. SmolVLM e Qwen3-VL respondem em cerca de 7 segundos nos topos de linha.
Transcrição de voz. O Whisper transforma sua voz em texto localmente. Segure para gravar e o texto aparece enquanto você fala. O áudio nunca sai do seu celular.
Ferramentas. Modelos com chamada de funções usam ferramentas embutidas: busca na web, calculadora, data e hora, informações do aparelho. O modelo encadeia tudo sozinho, com proteção contra loops infinitos.
Análise de documentos. Anexe PDFs, arquivos de código, CSVs e mais às suas conversas.
Quais modelos usar
O navegador de modelos do Off Grid filtra pela RAM do seu aparelho, então você nunca baixa algo que o celular não aguenta. Isto funciona em hardware de verdade:
Celulares com 6 GB de RAM: fique com modelos de 1 a 2 bilhões de parâmetros. Qwen 3 0.6B ou SmolLM3 são bons para começar. Espere de 5 a 10 tokens por segundo, o suficiente para respostas curtas e tarefas simples.
Celulares com 8 GB de RAM: o ponto ideal. Qwen 3 1.5B ou Phi-4 Mini dão respostas bem melhores. De 10 a 20 tokens por segundo nos Snapdragon recentes.
Celulares com 12 GB de RAM ou mais: dá para rodar modelos 7B como Llama 3.2 7B ou Qwen 3 4B. Em muitas tarefas eles chegam perto do primeiro ChatGPT. De 15 a 30 tokens por segundo no Snapdragon 8 Gen 3.
A quantização faz diferença. Um modelo quantizado em Q4_K_M usa mais ou menos metade da memória da versão completa, com perda mínima de qualidade. No celular, escolha sempre Q4 ou Q5.
Se você já tem modelos baixados, pode importar seus próprios arquivos .gguf do armazenamento do aparelho.
Como a IA local funciona no seu celular
Com IA local, os pesos do modelo são carregados na RAM do celular e os cálculos rodam no seu processador. Nenhum servidor participa. Depois que você baixa um modelo do Hugging Face, tudo acontece no seu aparelho.
O Off Grid usa o llama.cpp por baixo, o mesmo motor da maior parte da IA local em computadores. Ele é compilado para ARM64 e usa a aceleração que o seu celular oferecer: a NPU da Qualcomm via QNN, a GPU Adreno via OpenCL ou a CPU com instruções ARM NEON.
Ou seja, suas conversas, documentos e imagens nunca passam pela rede. Dá para conferir ligando o modo avião: tudo continua funcionando.
Aceleração por hardware
O Off Grid detecta seu hardware e escolhe sozinho o caminho mais rápido:
Snapdragon 8 Gen 1 ou mais novo com QNN: a NPU dedicada é bem mais rápida e econômica que a CPU ou a GPU. Com Snapdragon 8 Gen 2 ou Gen 3, é o caminho mais rápido. O Off Grid usa o QNN automaticamente quando ele está disponível.
GPU Adreno via OpenCL: disponível na maioria dos celulares Snapdragon. Mais rápida que a CPU sozinha, boa opção para Snapdragon mais antigos.
Só CPU: funciona em todos. Mais lenta, mas serve para modelos menores.
O truque do cache KV que triplica a velocidade
É o maior ganho de desempenho, e quase ninguém conhece. O cache KV guarda o contexto da conversa. Por padrão ele usa f16 (ponto flutuante de 16 bits). Nas configurações do Off Grid você pode trocar para q4_0 (quantização de 4 bits).
Trocar de f16 para q4_0 quase triplica a velocidade, com impacto mínimo na qualidade na maioria dos modelos. O app sugere a troca depois da sua primeira resposta.
Memória, o limite de verdade
Seu celular tem 8 GB de RAM, mas o sistema usa de 3 a 4 GB. Na prática sobram uns 4 GB para a IA.
Uma regra prática: tamanho do arquivo do modelo × 1,5 = RAM necessária durante o uso (o extra vai para o cache KV e os cálculos intermediários). Um modelo de 4 GB precisa de uns 6 GB de RAM livre.
O Off Grid confere a RAM disponível antes de carregar cada modelo e avisa se ele não cabe. Assim você evita o fechamento silencioso que acontece quando o sistema mata um app que usa memória demais. Você vê um aviso claro em vez de um app que fecha do nada.
Por que IA local em vez da nuvem
A IA local no celular tira três dependências de uma vez.
Sem assinatura. IA na nuvem custa a partir de US$ 20 por mês. IA local é grátis depois que você baixa o modelo uma vez.
Sem internet. Modelos locais funcionam no avião, no subsolo ou em países com internet restrita. Sem conexão, sem interrupção.
Sem expor seus dados. O que você digita numa IA na nuvem fica guardado num servidor que você não controla. No modo local, suas dúvidas de saúde, documentos jurídicos, diário pessoal e anotações confidenciais de trabalho nunca saem do seu aparelho. O Off Grid é de código aberto, então você não precisa acreditar na palavra de ninguém sobre privacidade. Leia o código você mesmo.
Como começar
- Instale o Off Grid pela Play Store
- Abra o navegador de modelos e escolha um recomendado para a RAM do seu aparelho
- Baixe o modelo pelo Wi-Fi (de 80 MB a mais de 4 GB)
- Ligue o modo avião para conferir que tudo roda localmente
- Comece a conversar
A primeira resposta demora mais porque o modelo está sendo carregado na memória. As seguintes são mais rápidas. Nas configurações, troque o cache KV para q4_0 para ter a melhor velocidade.
O que vem por aí
A próxima geração do Snapdragon da Qualcomm deve chegar a 200 tokens por segundo em IA local. O Galaxy S26 da Samsung já vem com IA embutida no aparelho. E as técnicas de otimização tiram cada vez mais qualidade de modelos cada vez menores.
O Off Grid está em desenvolvimento ativo, com recursos novos toda semana. Modo de voz, ferramentas, cache KV configurável e visão chegaram todos no último mês. Veja as versões mais recentes no GitHub.
Daqui a um ano, rodar IA local no celular não vai ser coisa de especialista. Vai ser o normal.