

Nesta página
O A17 Pro do seu iPhone tem um Neural Engine de 16 núcleos que faz 35 trilhões de operações por segundo. A Apple usa isso para processar fotos e para o corretor automático. Você pode usar para rodar modelos de IA completos no próprio aparelho: sem iCloud, sem assinatura, sem nenhum dado saindo do celular.
O Off Grid é um app gratuito e de código aberto que roda modelos de IA localmente no seu iPhone. Depois do primeiro download do modelo, não precisa mais de internet. Não precisa de Apple ID para os recursos de IA. Nenhum dado é enviado para lugar nenhum. Este guia mostra como configurar, quais modelos funcionam melhor no iOS e qual velocidade esperar.
| App Store | GitHub |
O que você precisa
Mínimo: iPhone com 6 GB de RAM (iPhone 13 Pro ou mais novo), chip A16 ou A17. Dá para começar com modelos de só 80 MB.
Recomendado: iPhone 15 Pro ou mais novo (8 GB de RAM). Aí você roda modelos de 3 bilhões de parâmetros ou mais, que dão respostas realmente úteis.
O que você abre mão em relação à IA na nuvem: serviços como ChatGPT e Claude rodam modelos de centenas de bilhões de parâmetros em GPUs de data center. Rodar no iPhone significa usar modelos menores (de 1 a 7 bilhões de parâmetros). As respostas são menos sofisticadas em raciocínios complexos, mas para o dia a dia, como perguntas rápidas, resumos, rascunhos e análise de documentos, elas surpreendem.
O que o Off Grid faz
O Off Grid não é só um chatbot de texto. Ele roda seis recursos de IA num só app, tudo no seu aparelho:
 Exemplo de conversa (iPhone) |
 Geração de imagens (iPhone) |
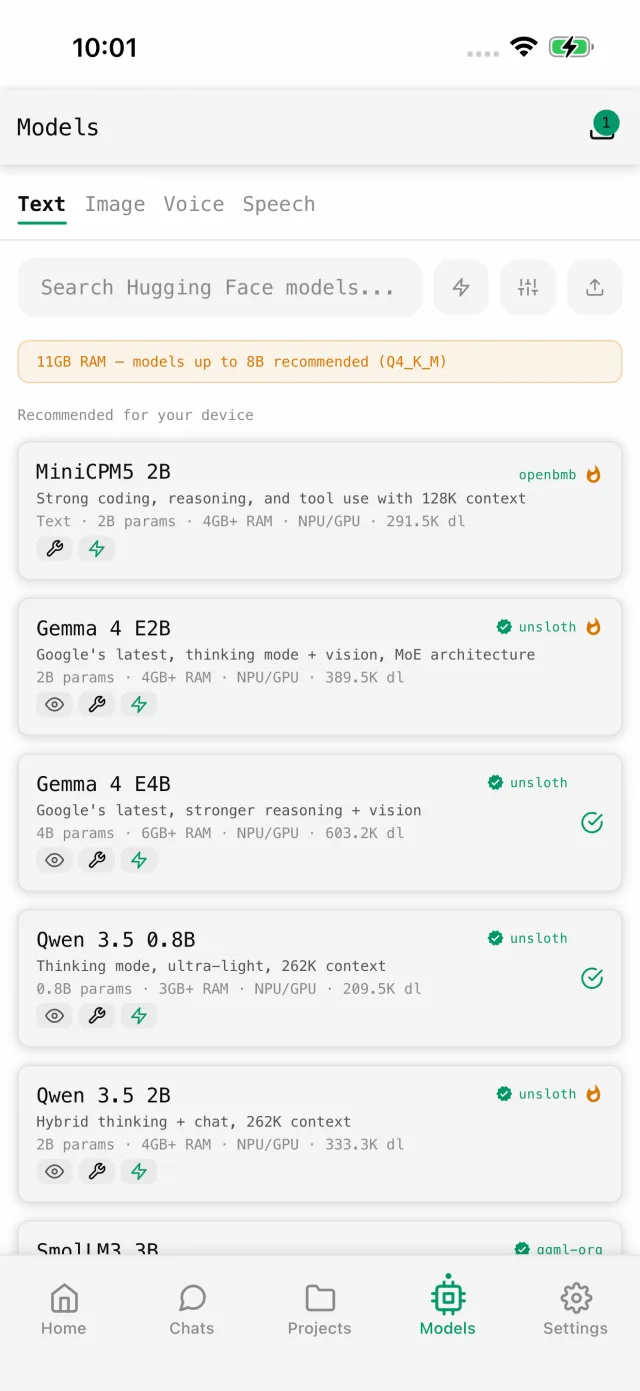 Modelos disponíveis (iPhone) |
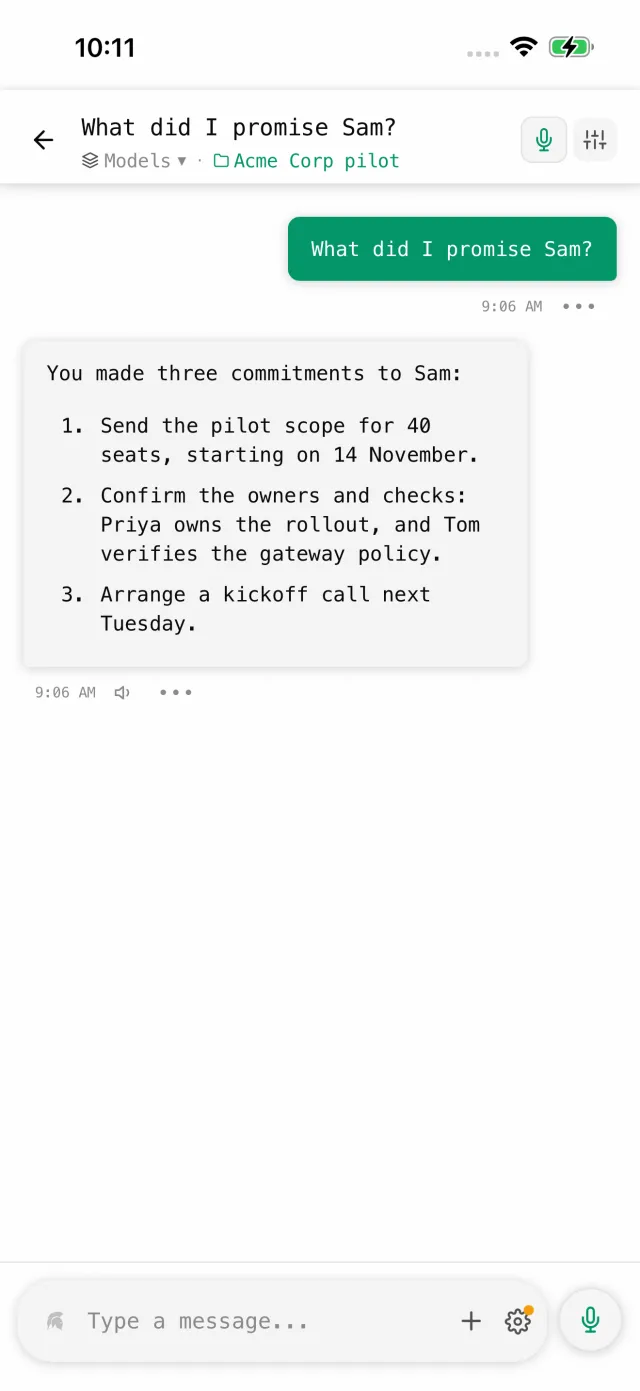 Documentos do projeto (iPhone) |
Texto. Rode Qwen 3, Llama 3.2, Gemma 3, Phi-4 ou qualquer modelo GGUF. Respostas aparecem enquanto são geradas, com Markdown. A aceleração por GPU via Metal em todos os iPhones recentes dá de 15 a 25 tokens por segundo.
Imagens. Stable Diffusion local pelo pipeline Core ML da Apple, acelerado pelo Neural Engine. Inclui SD 1.5, SD 2.1 e SDXL otimizados para iOS.
Visão. Aponte a câmera para algo ou anexe uma imagem e pergunte. SmolVLM e Qwen3-VL respondem em uns 7 segundos no iPhone 15 Pro.
Transcrição de voz. Whisper local. Segure para gravar, a transcrição aparece enquanto você fala. Nenhum áudio sai do seu celular.
Ferramentas. Modelos com chamada de funções usam ferramentas embutidas: busca na web, calculadora, data e hora, informações do aparelho. O modelo encadeia tudo sozinho, com proteção contra loops sem fim.
Análise de documentos. Anexe PDFs, arquivos de código, CSVs e mais às conversas. No iOS, o PDFKit extrai o texto direto.
Quais modelos usar
O navegador de modelos do Off Grid filtra pela RAM do seu aparelho, então você nunca baixa algo que o seu iPhone não roda. Veja como fica em hardware de verdade:
iPhones com 6 GB de RAM (iPhone 13 Pro, 14 Pro): fique com modelos de 1 a 2 bilhões de parâmetros. Qwen 3 0.6B ou SmolLM3 são bons pontos de partida. Conte com 8 a 12 tokens por segundo. Bom para respostas curtas e tarefas simples.
iPhones com 8 GB de RAM (iPhone 15 Pro, 16 Pro): o ponto ideal. Qwen 3 1.5B ou Phi-4 Mini dão respostas bem melhores. De 15 a 25 tokens por segundo com aceleração Metal.
Quantização faz diferença. Um modelo quantizado em Q4_K_M usa mais ou menos metade da memória da versão completa, quase sem perda de qualidade. No celular, escolha sempre Q4 ou Q5.
Se você já tem modelos baixados, pode importar seus próprios arquivos .gguf do armazenamento do aparelho.
Como a IA local funciona no seu iPhone
Quando você roda IA localmente, os pesos do modelo vão para a RAM do iPhone e o cálculo acontece no seu processador. Nenhum servidor envolvido. Depois que você baixa um modelo do HuggingFace, cada cálculo acontece no seu aparelho.
O Off Grid usa o llama.cpp compilado para Apple Silicon com aceleração por GPU via Metal. É o mesmo motor da maioria das IAs locais no Mac. Ele roda direto na GPU do iPhone, bem mais rápido que só na CPU.
Para imagens, o Off Grid usa o pipeline de Stable Diffusion em Core ML da própria Apple, no Neural Engine, com o máximo de eficiência. O mesmo hardware que a Apple usa na fotografia computacional agora gera suas imagens.
Resultado: suas conversas, seus documentos e suas imagens nunca tocam a rede. Confira no modo avião. Tudo funciona.
Memória no iOS
O iOS fecha sem dó os apps que usam memória demais. Um modelo que cabe na RAM no papel ainda pode ser fechado se o iOS precisar de memória para outra coisa.
O Off Grid confere a memória antes de carregar. Ele calcula a RAM realmente necessária (tamanho do arquivo x 1,5 para modelos de texto) e compara com a memória livre. Em aparelhos com 4 GB de RAM ou menos, a aceleração por GPU é desligada sozinha para evitar travamentos na alocação do Metal.
Se um modelo não couber, você vê um aviso claro, em vez de o app fechar sem explicação.
O truque do cache KV que triplica a velocidade
É o maior ganho de desempenho que a maioria das pessoas deixa passar. O cache KV guarda o contexto da conversa. Por padrão, ele usa f16 (ponto flutuante de 16 bits). No Off Grid, você muda para q4_0 (quantização de 4 bits) nas configurações.
Passar de f16 para q4_0 deixa tudo mais ou menos três vezes mais rápido, com impacto mínimo na qualidade da maioria dos modelos. O app sugere isso depois da primeira geração.
Por que rodar IA no aparelho e não na nuvem
Rodar IA no iPhone tira três dependências de uma vez.
Sem assinatura. IA na nuvem custa US$ 20 por mês ou mais. IA local é grátis depois do download único do modelo.
Sem internet. Modelos locais funcionam no avião, no subsolo, em qualquer lugar. Sem conexão, sem interrupção.
Sem expor seus dados. O que você digita numa IA na nuvem fica guardado num servidor que você não controla. Rodando localmente, suas dúvidas de saúde, documentos jurídicos, diário pessoal e anotações de trabalho nunca saem do aparelho. O Off Grid é de código aberto: você não precisa confiar na promessa de privacidade de ninguém, é só ler o código.
Comparado com a Apple Intelligence
A Apple Intelligence faz algumas tarefas no aparelho e manda outras para os servidores Private Cloud Compute da Apple. Ela se limita aos modelos da própria Apple e fica presa ao ecossistema dela. Você não escolhe o modelo, não consegue verificar o que roda no aparelho e o que vai para a nuvem, e não usa no Android.
O Off Grid roda tudo localmente. Você escolhe o modelo. Você confere o código. Funciona no iOS, no Android e no macOS. Sem jardim murado.
Como começar
- Instale o Off Grid pela App Store
- Abra o navegador de modelos e escolha um recomendado para a RAM do seu aparelho
- Baixe o modelo pelo Wi-Fi (de 80 MB a mais de 4 GB)
- Ligue o modo avião para confirmar que roda localmente
- Comece a conversar
A primeira resposta demora mais, enquanto o modelo carrega na memória. As seguintes são mais rápidas. Nas configurações, mude o cache KV para q4_0 para ter a melhor velocidade.
O Off Grid também roda nativamente nos Macs com Apple Silicon via Mac Catalyst. O mesmo app, os mesmos modelos, a mesma privacidade.
O que vem por aí
Os próximos chips da Apple devem deixar a IA local ainda mais rápida, e as técnicas de otimização tiram cada vez mais qualidade de modelos pequenos. A diferença entre IA local e na nuvem diminui a cada trimestre.
O Off Grid está em desenvolvimento ativo, com recursos novos toda semana. As versões mais recentes estão no GitHub.
Daqui a um ano, rodar IA no celular não vai ser truque de usuário avançado. Vai ser o padrão.