

Nesta página
O Qwen 3.5 é a família de modelos pequenos de pesos abertos mais capaz que existe hoje. A série pequena (0.8B, 2B, 4B, 9B) foi pensada desde o início para rodar no aparelho, e não destilada de um modelo maior. Ela combina Gated Delta Networks com uma mistura de especialistas (MoE) esparsa, fala mais de 200 idiomas e aguenta uma janela de contexto de 262K. E você pode rodá-la localmente no seu celular Android.
O Off Grid é um app gratuito e de código aberto que roda o Qwen 3.5 e outros modelos GGUF inteiramente no hardware do seu celular. Sem nuvem. Sem conta. Nenhum dado sai do seu aparelho.
| Play Store | GitHub |
Qual modelo do Qwen 3.5 combina com seu celular
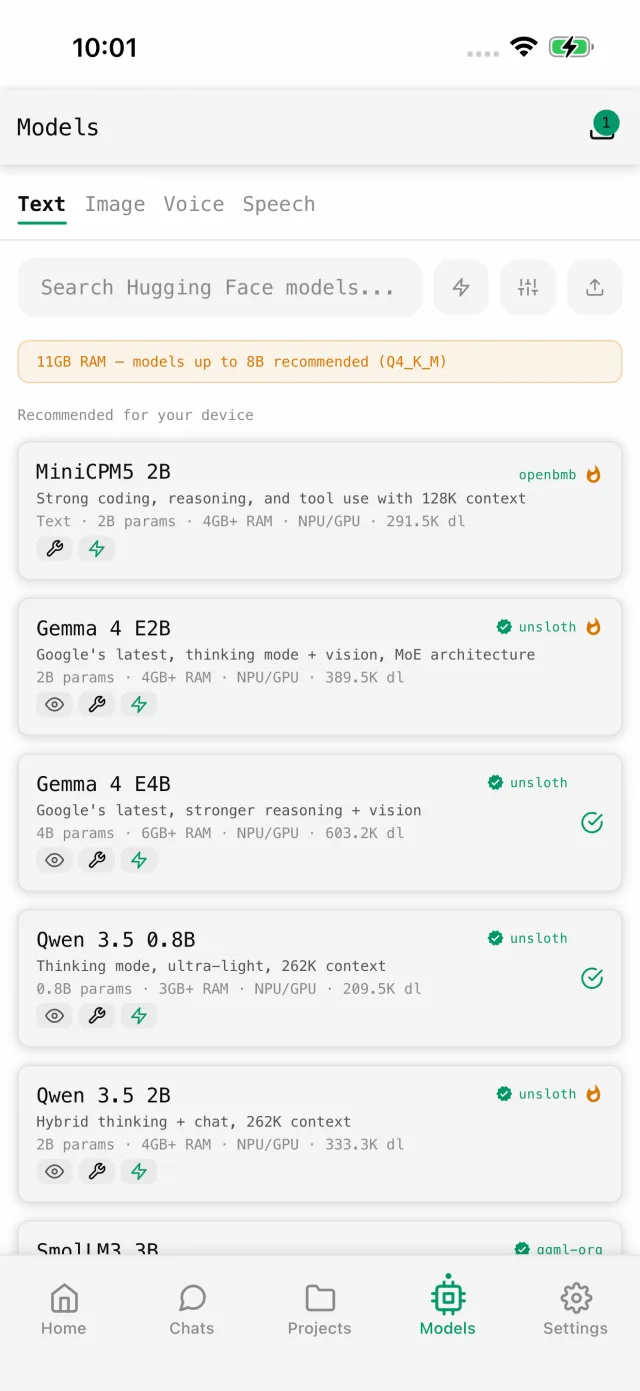
Qwen3.5-0.8B (Q4_K_M), cerca de 500 MB. Cabe em qualquer celular com 4 GB de RAM ou mais. Feito para o aparelho. Rápido: 15 a 25 tokens por segundo em intermediários. Muito capaz para o tamanho graças à arquitetura MoE, que ativa só uma parte dos parâmetros a cada token.
Qwen3.5-2B (Q4_K_M), cerca de 1,2 GB. O ponto ideal para celulares de 6 a 8 GB de RAM. Raciocina bem melhor que o 0.8B. De 10 a 18 tokens por segundo nos Snapdragon recentes. Bom para escrever, programar e trabalhar em vários idiomas.
Qwen3.5-4B (Q4_K_M), cerca de 2,5 GB. Precisa de 8 GB de RAM ou mais. É aqui que o Qwen 3.5 impressiona de verdade. A arquitetura híbrida faz ele render muito acima do número de parâmetros. Raciocínio em várias etapas, análise detalhada, geração de código.
Qwen3.5-9B (Q4_K_M), cerca de 5 GB. Precisa de 12 GB de RAM ou mais. Nos benchmarks, briga com modelos 20 vezes maiores. Se o seu celular tem a RAM, é o melhor modelo aberto que você consegue rodar localmente.
Por que o Qwen 3.5 e não outros modelos
Arquitetura híbrida. O Qwen 3.5 Small não é uma versão encolhida de um modelo grande. Ele combina Gated Delta Networks com mistura de especialistas e ativa só os parâmetros de que precisa a cada token. Mais inteligência por byte de RAM que os modelos densos tradicionais.
Mais de 200 idiomas. O suporte a idiomas mais amplo entre os modelos abertos desse tamanho. Se você trabalha em português, hindi, árabe, japonês ou qualquer idioma que não seja o inglês, o Qwen 3.5 é a melhor opção no celular.
Janela de contexto de 262K. Os modelos pequenos anteriores chegavam a 8K ou 32K. O Qwen 3.5 Small aguenta 262K tokens, então você pode mandar documentos inteiros e ter conversas longas sem ele perder o fio.
Modo de raciocínio. Alterne entre respostas rápidas e raciocínio passo a passo. O modo de raciocínio mostra a linha de pensamento do modelo e dá resultados melhores em problemas complexos.
Multimodal. O Qwen 3.5 entende texto, imagens e áudio de forma nativa. Aponte a câmera para algo e pergunte.
Desempenho em hardware de verdade
| Modelo | Snapdragon 8 Gen 3 | Snapdragon 8 Gen 2 | Intermediário |
|---|---|---|---|
| Qwen3.5-0.8B | ~25 tok/s | ~20 tok/s | ~12 tok/s |
| Qwen3.5-2B | ~18 tok/s | ~14 tok/s | ~8 tok/s |
| Qwen3.5-4B | ~12 tok/s | ~10 tok/s | ~5 tok/s |
| Qwen3.5-9B | ~8 tok/s | ~6 tok/s | - |
Mude o cache KV para q4_0 nas configurações e essas velocidades ficam mais ou menos três vezes maiores.
Como configurar o Qwen 3.5 no Off Grid
- Instale o Off Grid pela Play Store
- Abra o navegador de modelos: as versões do Qwen 3.5 estão na seção de recomendados
- Escolha o tamanho que combina com sua RAM
- Baixe pelo Wi-Fi
- Comece a conversar
O Off Grid usa sozinho a aceleração por NPU com QNN no Snapdragon 8 Gen 1 ou mais novo, a GPU Adreno via OpenCL em chips mais antigos e a CPU em todo o resto.
Privacidade
Cada resposta do Qwen 3.5 é calculada no processador do seu celular. Depois do download inicial, o Off Grid não faz nenhuma requisição de rede. Ligue o modo avião e confira. Tudo funciona.
Sem conta. Código aberto.
O Off Grid também gera imagens, entende fotos, transcreve voz, usa ferramentas e analisa documentos, tudo no aparelho. As versões mais recentes estão no GitHub.