

你的安卓手机 GPU 比大多数 2018 年的笔记本还强。新款骁龙芯片内置专用的 AI 加速器,可你每月花 20 美元,把 AI 跑在别人的服务器上,这些加速器却一直闲着。这种情况正在改变。
Off Grid 是一款免费、开源的应用,可以直接在安卓手机上本地运行 AI 模型。首次下载模型后就不再需要联网。不用注册账号,数据也不会离开你的设备。本指南介绍如何设置、该选哪些模型,以及在你的硬件上能达到什么性能。
| Play 商店 | GitHub |
你需要什么
最低配置: 6GB 内存,ARM64 处理器(近四五年的手机基本都满足)。可以从只有 80MB 的模型开始。
推荐配置: 8GB 以上内存,骁龙 8 Gen 2 或更新的芯片。这样就能运行 30 亿到 70 亿参数的模型,回答质量真正好用。
和云端 AI 的区别: ChatGPT、Claude 等服务在数据中心的 GPU 上运行数千亿参数的模型。手机本地运行的是更小的模型(10 亿到 70 亿参数)。复杂推理方面会弱一些,但对日常任务,比如快速提问、总结、起草和分析文档,表现出人意料地好。
Off Grid 能做什么
Off Grid 不只是一个文字聊天机器人。它把六种 AI 能力整合在一个应用里,全部在你的设备上运行:
 聊天示例(iPhone) |
 图片生成(iPhone 上展示) |
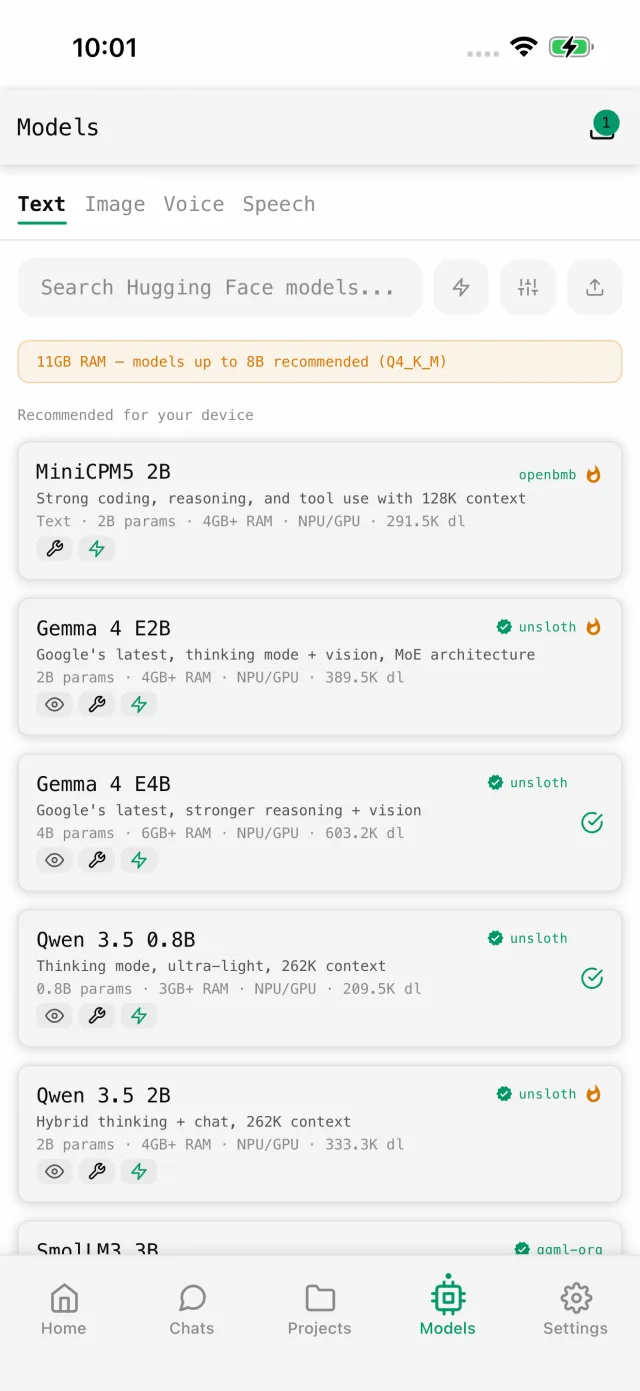 可用模型(iPhone) |
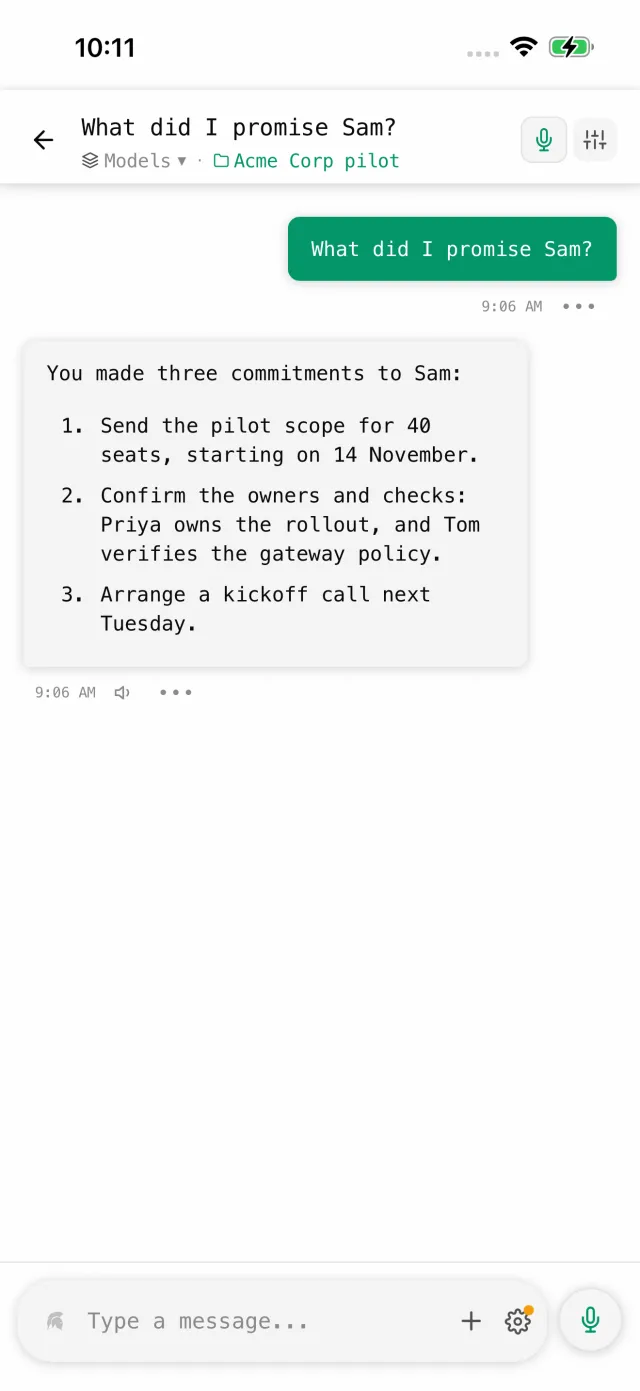 项目文档(iPhone) |
文本生成。 运行 Qwen 3、Llama 3.2、Gemma 3、Phi-4 或任意 GGUF 模型。回答逐字流式输出,支持 Markdown。旗舰机每秒 15 到 30 个 token,中端机每秒 5 到 15 个。
图片生成。 本地运行 Stable Diffusion,带实时预览。骁龙芯片上由 NPU 加速(每张 5 到 10 秒)。提供 20 多个模型,包括 Absolute Reality、DreamShaper 和 Anything V5。
视觉理解。 用摄像头对准某样东西,或附上一张图片,然后提问。SmolVLM 和 Qwen3-VL 在旗舰机上约 7 秒出结果。
语音转文字。 本地 Whisper 把语音转成文字。按住录音,边说边出字。音频从不离开你的手机。
工具调用。 支持函数调用的模型可以使用内置工具:网页搜索、计算器、日期时间、设备信息。模型会自动串联这些工具,并防止陷入死循环。
文档分析。 在对话中附上 PDF、代码文件、CSV 等。
该用哪些模型
Off Grid 的模型浏览器会按你设备的内存筛选,所以你不会下载手机跑不动的模型。以下是真机上的表现:
6GB 内存的手机: 选择 10 亿到 20 亿参数的模型。Qwen 3 0.6B 或 SmolLM3 都是不错的起点。速度约每秒 5 到 10 个 token,适合简短回答和简单任务。
8GB 内存的手机: 最佳平衡点。Qwen 3 1.5B 或 Phi-4 Mini 的回答质量明显更好。新款骁龙芯片上每秒 10 到 20 个 token。
12GB 以上内存的手机: 可以运行 Llama 3.2 7B 或 Qwen 3 4B 这类 7B 模型。很多任务上接近早期 ChatGPT 的水平。骁龙 8 Gen 3 上每秒 15 到 30 个 token。
量化很重要。 Q4_K_M 量化的模型内存占用约为全精度版本的一半,质量损失很小。在手机上请始终选择 Q4 或 Q5 量化。
如果你已经下载过模型,也可以从设备存储中导入自己的 .gguf 文件。
本地 AI 在手机上是怎么运行的
运行本地 AI 时,模型权重会加载到手机内存中,推理在你的处理器上完成。全程不经过任何服务器。从 Hugging Face 下载模型之后,所有计算都在你的设备上进行。
Off Grid 底层使用 llama.cpp,也就是桌面端大多数本地 AI 所用的引擎。它针对 ARM64 编译,并会用上手机提供的各种加速:通过 QNN 调用高通 NPU,通过 OpenCL 调用 Adreno GPU,或用支持 ARM NEON 指令的 CPU。
所以你的对话、文档和图片从不接触网络。打开飞行模式就能验证:一切照常运行。
硬件加速
Off Grid 会自动识别你的硬件,选择最快的路径:
骁龙 8 Gen 1 及以上(QNN): 专用 NPU 比 CPU 或 GPU 快得多,也更省电。骁龙 8 Gen 2 或 Gen 3 用这条路径最快。只要可用,Off Grid 会自动使用 QNN。
Adreno GPU(OpenCL): 大多数骁龙手机都支持。比只用 CPU 快,是较老骁龙机型的好选择。
仅 CPU: 所有手机都能用。速度较慢,但运行小模型没问题。
让速度提升三倍的 KV 缓存技巧
这是大多数人忽略的最大提速点。KV 缓存保存对话的上下文,默认使用 f16(16 位浮点)。在 Off Grid 的设置里可以改成 q4_0(4 位量化)。
从 f16 改成 q4_0,推理速度大约提升三倍,对大多数模型的质量影响很小。第一次生成完成后,应用会提示你进行这项优化。
内存才是真正的限制
你的手机有 8GB 内存,但系统会占用 3 到 4GB。真正能给 AI 用的大约只有 4GB。
粗略估算:模型文件大小 × 1.5 = 运行时实际需要的内存(多出的部分用于 KV 缓存和中间计算)。所以 4GB 的模型需要大约 6GB 空闲内存。
Off Grid 每次加载模型前都会检查可用内存,放不下时会提醒你。这样就不会因为系统强制关闭占用内存过多的应用而突然闪退。你看到的是一条清楚的提示,而不是应用莫名其妙地关掉。
为什么选本地 AI,而不是云端
在手机上运行本地 AI,一次摆脱三个依赖。
无需订阅。 云端 AI 每月 20 美元起。本地 AI 下载一次模型之后就免费。
无需联网。 本地模型在飞机上、地下室里、网络受限的国家都能用。没有网络,也就不会中断。
数据不外泄。 你在云端 AI 里输入的内容会存储在你无法控制的服务器上。本地运行时,你的健康问题、法律文件、私人日记和机密工作笔记都不会离开设备。Off Grid 是开源的,你不必相信任何人的隐私承诺,可以自己去看代码。
开始使用
- 从 Play 商店安装 Off Grid
- 打开模型浏览器,选择适合你设备内存的推荐模型
- 连接 Wi-Fi 下载模型(大小从 80MB 到 4GB 以上)
- 打开飞行模式,确认一切都在本地运行
- 开始聊天
第一次生成会慢一些,因为模型要加载到内存里,之后的消息会更快。到设置里把 KV 缓存改成 q4_0,速度最快。
接下来
高通下一代骁龙芯片预计能让本地 AI 推理达到每秒 200 个 token。三星 Galaxy S26 自带设备端 AI。模型优化技术也在不断进步,让越来越小的模型有越来越好的质量。
Off Grid 正在积极开发,每周都有新功能上线。语音模式、工具调用、可配置的 KV 缓存和视觉功能都是上个月推出的。最新版本请看 GitHub。
一年后,在手机上运行本地 AI 将不再是高手的技巧,而是默认选项。