

本页内容
你 iPhone 里的 A17 Pro 有一颗 16 核神经网络引擎,每秒能做 35 万亿次运算。Apple 用它来处理照片和自动纠错。你可以用它在本地运行完整的 AI 模型:不用 iCloud,不用订阅,数据不离开手机。
Off Grid 是一款免费、开源的应用,可以在你的 iPhone 上本地运行 AI 模型。首次下载模型后就不再需要网络。AI 功能不需要 Apple ID。数据不发往任何地方。本文介绍如何设置、哪些模型在 iOS 上效果最好,以及能达到什么速度。
| App Store | GitHub |
你需要什么
最低配置: 6GB 内存的 iPhone(iPhone 13 Pro 及更新机型),A16 或 A17 芯片。最小的模型只有 80MB,可以从它开始。
推荐配置: iPhone 15 Pro 或更新机型(8GB 内存)。这样就能运行 3B 以上参数的模型,输出真正好用。
和云端 AI 相比少了什么: ChatGPT、Claude 这样的云端 AI 在数据中心的 GPU 上运行数千亿参数的模型。在 iPhone 上本地运行意味着用更小的模型(10 亿到 70 亿参数)。复杂推理上会弱一些,但对快速提问、总结、起草和文档分析这些日常任务,它的表现出人意料地好。
Off Grid 能做什么
Off Grid 不只是一个文字聊天机器人。它在一个应用里本地运行六种 AI 能力,全部在你的设备上:
 示例对话(iPhone) |
 图像生成(iPhone) |
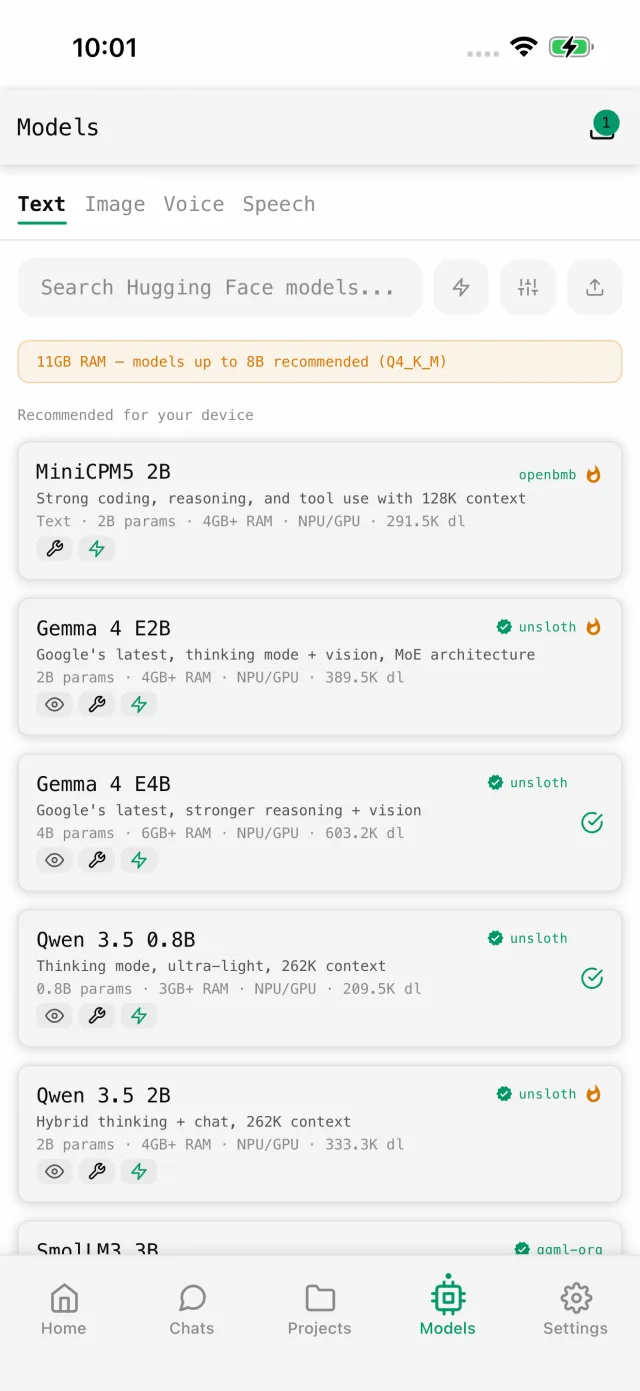 可用模型(iPhone) |
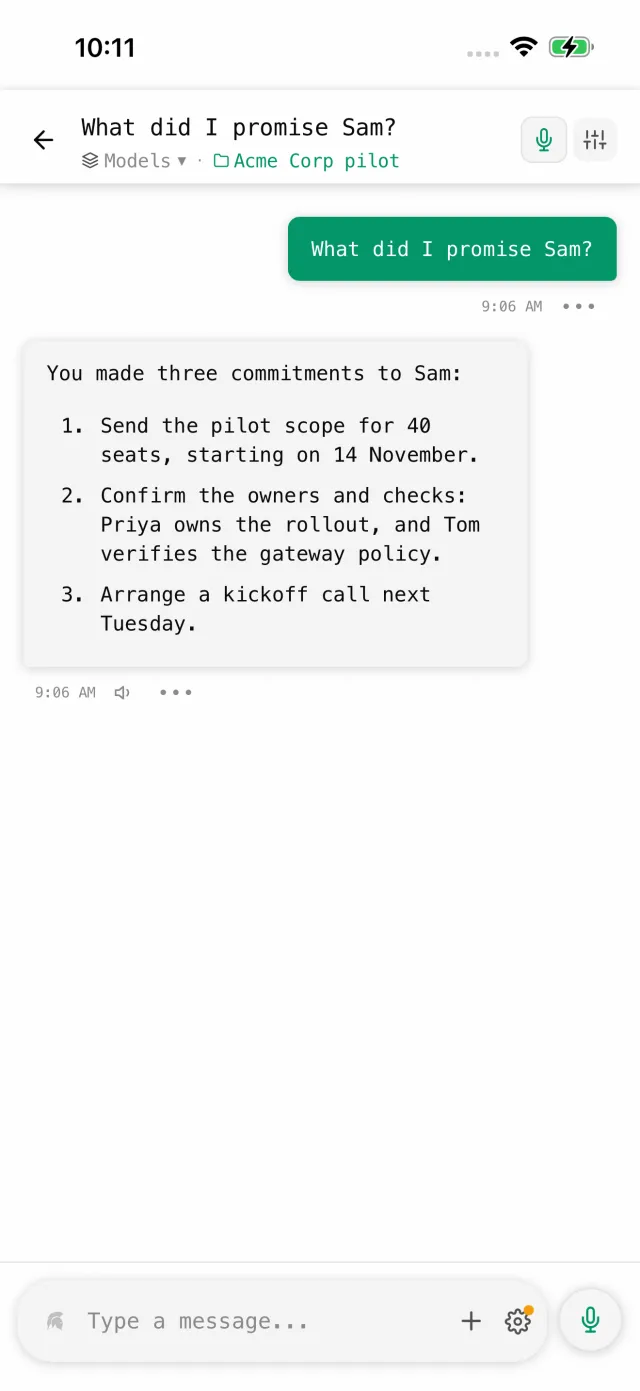 项目文档(iPhone) |
文本生成。 运行 Qwen 3、Llama 3.2、Gemma 3、Phi-4 或任何 GGUF 模型。回复逐字流式输出,支持 Markdown 渲染。所有新款 iPhone 都有 Metal GPU 加速,每秒 15 到 25 个 token。
图像生成。 通过 Apple 的 Core ML 流程在本地运行 Stable Diffusion,用神经网络引擎加速,生成很快。模型包括针对 iOS 优化的 SD 1.5、SD 2.1 和 SDXL。
视觉 AI。 用摄像头对准一样东西,或附上一张图片,然后提问。SmolVLM 和 Qwen3-VL 在 iPhone 15 Pro 上大约 7 秒出结果。
语音转文字。 本地运行 Whisper。按住录音,实时显示部分转写。音频从不离开你的手机。
工具调用。 支持函数调用的模型可以使用内置工具:网页搜索、计算器、日期时间、设备信息。模型会自动把它们串起来循环调用,并防止失控。
文档分析。 在对话里附上 PDF、代码文件、CSV 等。iOS 上用原生 PDFKit 提取内容。
该用哪些模型
Off Grid 的模型浏览器会按你设备的内存筛选,你永远不会下载到 iPhone 跑不动的模型。以下是真机上的表现:
6GB 内存的 iPhone(iPhone 13 Pro、14 Pro): 用 1B 到 2B 的模型。Qwen 3 0.6B 或 SmolLM3 是不错的起点。每秒 8 到 12 个 token,适合简短回答和简单任务。
8GB 内存的 iPhone(iPhone 15 Pro、16 Pro): 最佳选择。Qwen 3 1.5B 或 Phi-4 Mini 的输出质量明显更好。借助 Metal GPU 加速,每秒 15 到 25 个 token。
量化很重要。 Q4_K_M 量化的模型占用的内存大约是全精度版本的一半,质量几乎没有损失。在手机上,始终选 Q4 或 Q5 量化。
如果你已经下载过模型,也可以从设备存储导入自己的 .gguf 文件。
本地 AI 在 iPhone 上是怎么运行的
本地运行 AI 时,模型权重会加载到 iPhone 的内存里,推理在你的处理器上完成,不涉及任何服务器。从 HuggingFace 下载模型之后,每一次计算都在你的设备上进行。
Off Grid 使用为 Apple Silicon 编译、带 Metal GPU 加速的 llama.cpp。Mac 上大多数本地 AI 用的也是这个引擎。它直接跑在 iPhone 的 GPU 上,比只用 CPU 快得多。
图像生成方面,Off Grid 使用 Apple 自己的 Core ML Stable Diffusion 流程,在神经网络引擎上运行,效率最高。Apple 用来做计算摄影的那块硬件,现在在为你生成 AI 图片。
结果就是:你的对话、你的文档、你的图片,全都不会碰到网络。打开飞行模式就能验证,一切照常运行。
iOS 上的内存安全
iOS 会果断结束占用内存太多的应用。一个模型就算理论上放得进内存,如果 iOS 觉得别处更需要内存,还是可能被结束。
Off Grid 会在加载前检查内存。加载任何模型之前,它先算出实际需要的内存(文本模型为文件大小 x 1.5),再和可用内存比较。在 4GB 内存及以下的设备上,GPU 加速会自动关闭,避免 Metal 缓冲区分配导致崩溃。
如果模型放不下,你会看到明确的提示,而不是应用悄悄关闭。
让速度翻三倍的 KV 缓存技巧
这是大多数人会错过的最大一项性能提升。KV 缓存保存着你对话的上下文,默认使用 f16(16 位浮点)。Off Grid 让你在设置里改成 q4_0(4 位量化)。
从 f16 换成 q4_0,推理速度大约提高到三倍,而大多数模型的质量几乎不受影响。第一次生成之后,应用会提示你做这项优化。
为什么在本地运行 AI,而不用云端
在 iPhone 上本地运行 AI,一次去掉三样依赖。
不用订阅。 云端 AI 每月 20 美元起。本地 AI 在一次性下载模型后就免费。
不用联网。 本地模型在飞机上、地下室里,任何地方都能用。没有网络也不会中断。
数据不外泄。 你在云端 AI 里输入的提示,会被存到你无法控制的服务器上。本地运行意味着你的健康问题、法律文件、私人日记和工作笔记都不会离开你的设备。Off Grid 是开源的,你不必相信谁的隐私承诺,自己读代码就行。
和 Apple Intelligence 比较
Apple Intelligence 有些任务在设备上运行,另一些则经由 Apple 的私有云计算服务器处理。它只能用 Apple 自己的模型,也被锁在 Apple 生态里。你选不了模型,无法验证哪些在本地、哪些在云端,也不能在 Android 上用。
Off Grid 全部在本地运行。模型你来选,代码你来验证。它支持 iOS、Android 和 macOS,没有围墙花园。
开始使用
- 从 App Store 安装 Off Grid
- 打开模型浏览器,选一个适合你设备内存的推荐模型
- 用 WiFi 下载模型(大小从 80MB 到 4GB 以上)
- 打开飞行模式,确认它在本地运行
- 开始聊天
第一次生成会慢一些,因为模型要加载到内存里,之后的消息会更快。进入设置,把 KV 缓存改成 q4_0,速度最快。
Off Grid 也通过 Mac Catalyst 在 Apple Silicon 的 Mac 上原生运行。同一个应用,同样的模型,同样的隐私。
接下来
Apple 的下一代芯片有望让本地 AI 推理更快,模型优化也在不断让小模型变得更好。本地 AI 和云端 AI 的差距每个季度都在缩小。
Off Grid 在持续开发中,每周都有新功能。最新版本请看 GitHub。
一年后,在手机上本地运行 AI 将不再是高手的技巧,而是默认的做法。